
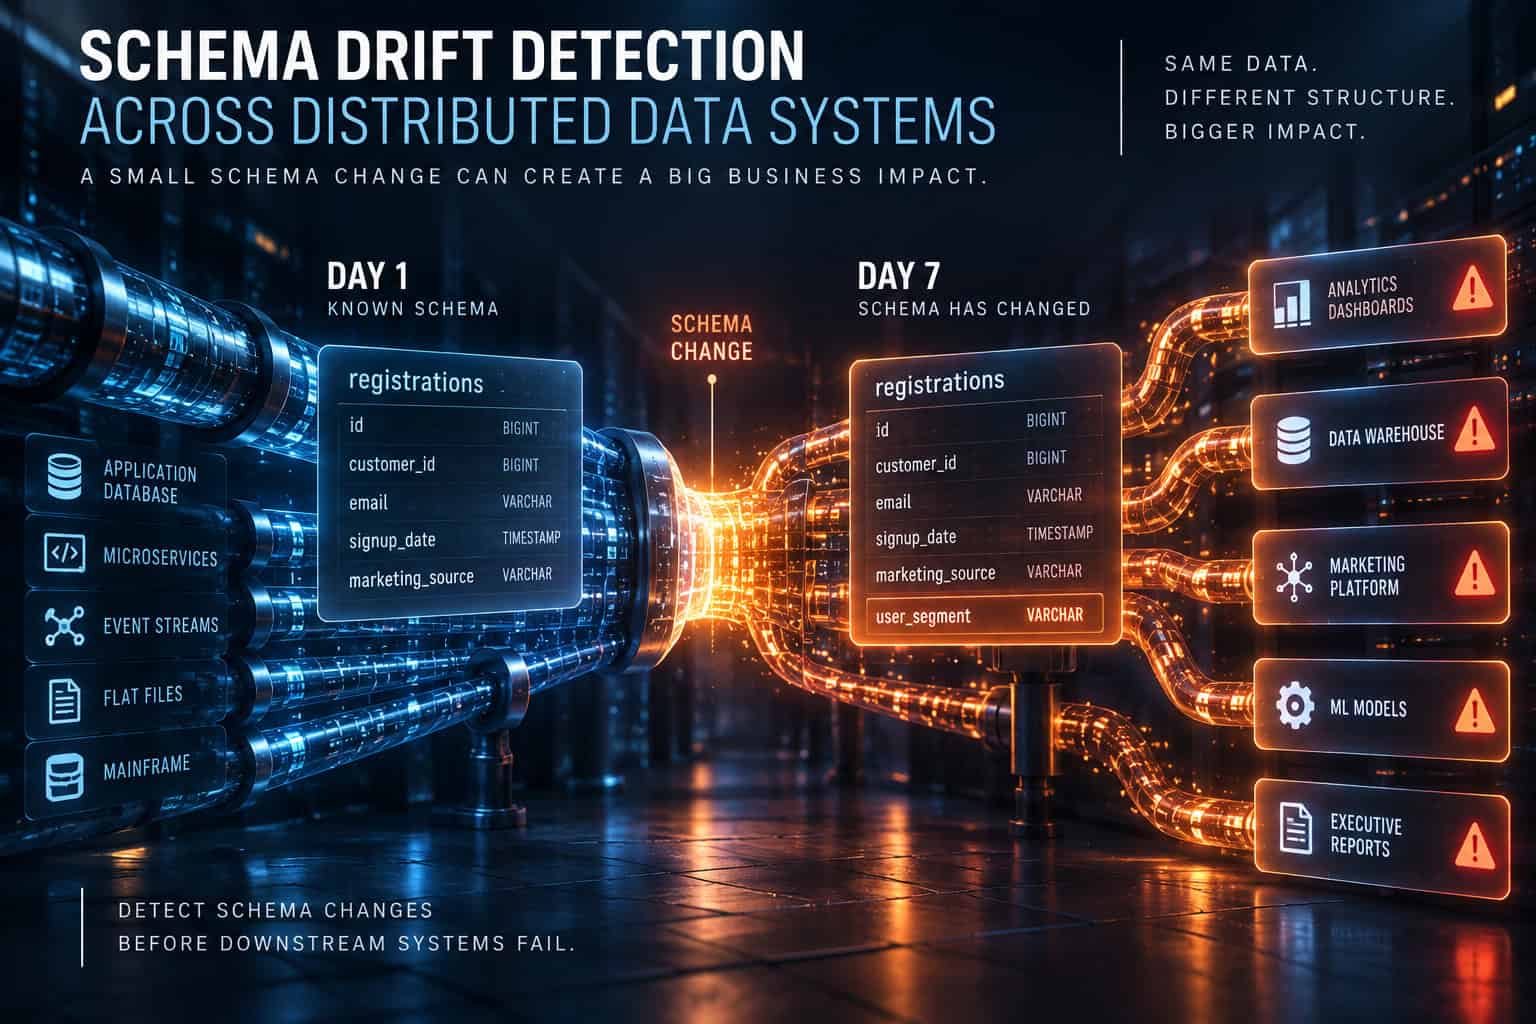
Analysedashboardet var korrekt tirsdag. Torsdag viste det et fald på 23 procent i kundeanskaffelser, hvilket forretningsteamet behandlede som et ægte forretningssignal, reorganiserede marketingbudgetter, satte kampagner på pause og eskalerede til bestyrelsen. Dataingeniørteamet opdagede fredag, at upstream-tjenesten havde tilføjet en kolonne, der kan nulliseres, til registrations tabel seks dage tidligere. ETL-pipelinen var ikke blevet opdateret. Beregningen, der udledte anskaffelsesmetrikken, behandlede de nye nullværdier som nuller i stedet for at ekskludere dem. Der var ikke sendt nogen meddelelse om skemaændring. Ingen kontrakt var blevet brudt på en måde, der medførte en fejl. Pipelinen kørte korrekt; den producerede forkerte tal, der så korrekte ud.
Schemadrift repræsenterer en strukturel mutation. I modsætning til problemer med datakvalitet, hvor værdierne er forkerte, bryder schemadrift kontrakten mellem kilde og destination. I et monolitisk databasemiljø med en central databaseadministrator, der kontrollerer al DDL, håndhæves denne kontrakt af en enkelt myndighed. I et distribueret system, hvor snesevis af uafhængige tjenester hver ejer deres eget datalager, hvor eventstreams bærer Avro-skemaer, der udvikler sig uafhængigt, og hvor flade filgrænseflader mellem mainframe-batchjob og cloud-analyseplatforme definerer implicitte kontrakter, der ikke findes i nogen af systemernes dokumentation, distribueres kontrakten på tværs af alle grænser i systemet. Schemadrift i et distribueret miljø venter ikke på, at en databaseadministrator begår en fejl. Det opstår som følge af den normale drift af autonome teams, der træffer individuelt fornuftige beslutninger uden fuldstændig indsigt i alle downstream-forbrugere af deres data.
Kortlæg grænsen for det ældre skema
SMART TS XL identificerer alle fladfilformatkontrakter, der forbinder mainframe-programmer med moderne analyseplatforme.
FÅ MERE AT VIDE…Hvad skemadrift er, og hvad det ikke er
Schemadrift er en ændring i strukturen af en dataartefakt, der ikke afspejles i forbrugerne af den pågældende artefakt. Vægten på forbrugere er det, der adskiller drift fra planlagt migrering: en kolonneomdøbning, der udføres samtidigt i kildetabellen, og hver forbrugerforespørgsel er en skemamigrering. Den samme omdøbning, der kun udføres i kildetabellen, hvilket efterlader forbrugerne med forældede kolonnenavne, er skemadrift.
Datapipelines er afhængige af en tillidskontrakt mellem kildesystemet og destinationslageret. Denne kontrakt er skemaet: den aftalte struktur, datatyper og kolonnenavne, der definerer datasættet. Når upstream-teams ændrer deres applikationsdatabase uden at underrette datateamet, bryder de denne kontrakt.
Skemadrift er ikke det samme som datadrift. Datadrift er en ændring i den statistiske fordeling af værdier inden for et stabilt skema, gennemsnitlige ordensværdier der falder, nul-rater der stiger, og kategoriske fordelinger der skifter. Begge er vigtige signaler om datakvalitet, men de kræver forskellige detektionsmetoder og indikerer forskellige rodårsager. Et system til detektion af skemaændringer, der overvåger kolonnenavne og -typer, vil ikke fange datadrift; et distributionsovervågningssystem vil ikke fange tilføjelser og fjernelser af kolonner.
Schemadrift er heller ikke altid skadeligt. Sporing af driftens sværhedsgrad over tid hjælper med at skelne mellem aktive udviklingscyklusser (godartet drift) og ustabilitet (kritisk drift). En bagudkompatibel tilføjelse af en nullbar kolonne til en tabel er schemadrift, skemaet ændret, men det ødelægger muligvis ikke nogen forbruger, der ignorerer den nye kolonne. Klassificeringen af drift som godartet eller kritisk kræver forståelse af downstream-forbrugerne og hvordan de håndterer ændringen.
De fire typer af skemadrift
Distribuerede datasystemer producerer skemadrift langs fire forskellige dimensioner, der hver især kræver forskellige detektionsmekanismer:
Type 1: Strukturel drift
Ændringer i den fysiske skemadefinition: kolonnetilføjelser, kolonnefjernelser, kolonneomdøbninger, ændringer af datatyper, tilføjelser eller fjernelser af begrænsninger, tilføjelser og fjernelser af tabeller. Dette er den mest synlige form for skemadrift og den, der oftest adresseres af observationsværktøjer. Database INFORMATION_SCHEMA-forespørgsler, sammenligninger af skemaregistre og revisionslogfiler for migreringsværktøjer registrerer effektivt strukturel drift for forbundne systemer.
Detektion: Sammenligning af skema-snapshots med en baseline; INFORMATION_SCHEMA-afstemning; sammenligning af skema-registerversioner.
Type 2: Semantisk afvigelse
Ændringer i betydningen af et eksisterende felt uden ændringer i dets definition. En kolonne med navnet
statussom tidligere indeholdt værdierACTIVE,INACTIVE,PENDINGindeholder nu værdier1,2,3fordi den producerende tjeneste ændrede sin optælling. Skemaet, kolonnenavnet, datatypen og den nullable begrænsning er uændret. Den semantiske kontrakt er brudt. Forbrugere, der har parset strengstatusværdier, modtager nu heltal, som deres logik ikke håndterer.Semantisk drift og kontekstdrift er nyere i samtalen og overvåges dramatisk mindre, selvom begge er ansvarlige for en voksende andel af AI-programfejl. Semantisk drift er den sværeste at opdage automatisk, fordi den ikke producerer noget strukturelt signal, men kræver enten overvågning af værdifordeling (forholdet mellem kendte værdier og ukendte værdier ændres) eller eksplicit kontrakttestning.
Detektion: Overvågning af værdifordeling; valideringsregler for tilladte værdier; kontrakttests, der bekræfter specifikke gyldige værdier.
Type 3: Formatforskydning
Ændringer i kodningen eller formatet af værdier inden for strukturelt uændrede felter. Et tidsstempelfelt, der tidligere indeholdt UTC ISO 8601-strenge, indeholder nu Unix-epoch-heltal. Et valutafelt, der tidligere indeholdt decimalbeløb, indeholder nu beløb i cent som heltal. Kolonnen findes, typen er stadig gyldig for de nye værdier, men parsingkonventionen er ændret.
Formatdrift er særligt almindelig ved grænserne af distribuerede systemer, hvor én tjeneste serialiserer data i et format, som en anden deserialiserer, og ved grænsen mellem ældre og moderne, hvor COBOL-programmer skriver flade filer med specifikke bytepositionskonventioner, som downstream ETL-processer er afhængige af.
Detektion: Statistisk profilering af værdiintervaller og -mønstre; formatvalideringsregler for specifikke felter; grænsekontrakttest.
Type 4: Kontraktforskydning
Ændringer i en datakildes tilgængeligheds-, friskheds- eller volumengarantier. Kildesystemet leverede tidligere et datasæt inden kl. 3 UTC dagligt; det leverer nu inden kl. 6, hvilket lydløst afbryder downstream-processer, der antog friskhed kl. 3. Kildesystemet garanterede tidligere mindst 1,000 poster om dagen; perioder med lav trafik producerer nu færre. Ingen af ændringerne er en skemaændring i strukturel forstand, men begge bryder kontrakten mellem producent og forbruger.
Detektion: Friskhedsovervågning; detektion af volumenafvigelser; SLA-baseret alarmering.
Hvorfor distribuerede systemer forstærker problemet
I et monolitisk system med en enkelt database og et enkelt applikationsteam er skemaændringer kontrollerede hændelser. DBA'en skriver migreringen, udvikleren opdaterer forespørgslerne, og ændringen implementeres samlet. Risikoen for skemaafvigelse eksisterer, men er begrænset af omfanget af den enkelte myndighed.
Distribuerede systemer fjerner denne ene autoritet. Hver tjeneste ejer sine data. Hvert team træffer skemabeslutninger uafhængigt. Forbrugerne af hver tjenestes data er ofte uden for teamets umiddelbare bevidsthed, især når forbrugeren er en dataplatform, en analysepipeline eller et ældre integrationspunkt, som intet produktteam aktivt vedligeholder.
Distributed Schema Drift Propagation Path:

Order Service          Kafka Topic           Analytics Pipeline
┌─────────────────┐   ┌───────────────┐    ┌──────────────────────┐
│ orders table    │──>│ order.created │───>│ orders_fact table    │
│ + coupon_id     │   │ Avro schema   │    │ (missing coupon_id)  │
│   (new column)  │   │ v1 still used │    │ pipeline runs fine   │
│                 │   │               │    │ coupon data silently  │
│                 │   │               │    │ dropped              │
└─────────────────┘   └───────────────┘    └──────────────────────┘

                           ▼
                   BI Dashboard
                ┌──────────────────┐
                │ coupon_revenue   │
                │ always = $0      │
                │ (no error shown) │
                └──────────────────┘
Diagrammet illustrerer udbredelsesmønsteret: Order Service-teamet tilføjer coupon_id til deres database. Hvis de også opdaterer Kafka-hændelsesskemaet til at inkludere coupon_id, skal analysepipelinen opdateres for at kunne forbruge den. Hvis Kafka-skemaet stadig er på version 1, når feltet aldrig pipelinen. Hvis pipelinen opdateres, men BI-dashboardmodellen ikke opdateres, findes feltet i lageret, men mangler i rapporten. Driften kan medføre et stille datatab ved en hvilken som helst af fire grænser, og hver grænse kræver en forskellig detektionsmekanisme.
Stille pipelinefejl, forældede dashboards, skemadrift og ufuldstændige datasæt er blevet store operationelle risici i moderne virksomhedsdatamiljøer. Moderne datastakke fejler hurtigere end traditionelle miljøer, med ødelagte transformationer, fejl i aktualitet og stille datakorruption, der spreder sig på tværs af pipelines længe før teams registrerer problemer manuelt.
Den "stille" egenskab er det, der gør distribueret skemadrift dyr. En fejl, der producerer en undtagelse, opdages og rettes. En ændring, der producerer lydløst forkerte tal, kører uopdaget, indtil en forretningsbeslutning baseret på disse tal producerer en synlig konsekvens.
Detektionsmetoder efter lag
Detektion af skemadrift kræver forskellige værktøjer og teknikker for hvert lag i et distribueret system:
Database- og lagerlag
Det mest modne detektionslag. INFORMATION_SCHEMA-tabeller i alle større databaser og warehouses giver et forespørgselsbaseret metadata-øjebliksbillede:
sql
-- Detect structural schema changes since a baseline snapshot
-- Run daily; alert when new differences appear

WITH current_schema AS (
    SELECT
        table_name,
        column_name,
        data_type,
        is_nullable,
        column_default,
        ordinal_position
    FROM information_schema.columns
    WHERE table_schema = 'production'
),
baseline AS (
    -- Previous snapshot stored in schema_baseline table
    SELECT * FROM schema_monitoring.schema_baseline
    WHERE snapshot_date = CURRENT_DATE - 1
)
SELECT
    'ADDED'   AS change_type,
    c.table_name,
    c.column_name,
    c.data_type,
    CURRENT_DATE AS detected_date
FROM current_schema c
LEFT JOIN baseline b
    ON c.table_name = b.table_name
    AND c.column_name = b.column_name
WHERE b.column_name IS NULL

UNION ALL

SELECT
    'REMOVED' AS change_type,
    b.table_name,
    b.column_name,
    b.data_type,
    CURRENT_DATE
FROM baseline b
LEFT JOIN current_schema c
    ON b.table_name = c.table_name
    AND b.column_name = c.column_name
WHERE c.column_name IS NULL

UNION ALL

SELECT
    'TYPE_CHANGED' AS change_type,
    c.table_name,
    c.column_name,
    c.data_type || ' (was: ' || b.data_type || ')' AS data_type,
    CURRENT_DATE
FROM current_schema c
JOIN baseline b
    ON c.table_name = b.table_name
    AND c.column_name = b.column_name
WHERE c.data_type <> b.data_type;
Værktøjer, der automatiserer dette mønster: dbt-skematests, Great Expectations-kolonneforventninger, Monte Carlo-tabeltilstandsovervågning, Acceldata-skemadriftsovervågning.
Lag til eventstreaming
Kafka-emner bruger skemaregistre (Confluent Schema Registry, AWS Glue Schema Registry, Apicurio) til at styre Avro-, Protobuf- og JSON-skemaudviklingen. Registret håndhæver kompatibilitetsregler på udgivelsestidspunktet:
yaml
# Confluent Schema Registry: compatibility rule configuration
# Applied per topic; enforces at producer registration time

compatibility:
  BACKWARD:
    # New schema can read data written with old schema
    # Safe: consumers can be updated after producers
    allows: add_optional_fields, remove_fields_with_defaults
    blocks: rename_fields, change_types, add_required_fields

  FORWARD:
    # Old schema can read data written with new schema
    # Safe: consumers can be deployed before producers
    allows: add_required_fields, rename_with_aliases
    blocks: remove_fields_used_by_consumers

  FULL:
    # Both backward and forward compatible
    # Strictest: ensures zero-downtime evolution
    allows: add_optional_fields_with_defaults
    blocks: everything_else
Skemaregistret forhindrer ikke semantisk drift, et felt hvis navn og type er uændret, men hvis betydning er ændret, består kompatibilitetstjek. Kontrakttestning (Pact, AsyncAPI-testning) er påkrævet for semantisk validering.
API-lag
Der er fire fundamentalt forskellige tilgange til at opdage API-skemaafvigelser: Spec-to-specific diffing, spec-to-reality monitoring, reality-to-reality monitoring og trafikbaseret detektion. Mest forvirring på dette område stammer fra folk, der sammenligner værktøjer på tværs af forskellige tilgange.
For interne service-API'er i en mikroservicearkitektur er forbrugerdrevet kontrakttestning (Pact) den mest pålidelige tilgang: hver forbruger specificerer den kontrakt, den kræver fra producenten, kontrakterne verificeres mod producentens implementering i CI, og enhver ændring, der bryder en forbrugers kontrakt, fejler i producentens testsuite før implementering.
Legacy-systemets grænser: Hvor drift bliver usynlig
Alle de ovenfor beskrevne detektionsmetoder fungerer for systemer, der eksponerer skemametadata via forespørgbare grænseflader: INFORMATION_SCHEMA, skemaregistre, OpenAPI-specifikationer. Ved grænsefladen mellem ældre mainframe-systemer og moderne dataplatforme findes disse grænseflader ikke.
Et COBOL-program, der producerer en natlig flad fil til brug i en cloud-ETL-pipeline, definerer et implicit skema i sin FD-indgangs- og outputlogik. "Skemaet" for den flade fil, bytepositionerne, datatyperne, COMP-3-pakkede decimalfelter og REDEFINES-strukturerne findes i COBOL-kildekoden, ikke i noget register eller metadatalager, som moderne observationsværktøjer kan forespørge.
COBOL
      *> This FD entry IS the schema contract for the nightly extract
      *> Any change here constitutes schema drift for the downstream ETL
       FD  CUSTOMER-EXTRACT-FILE
           LABEL RECORDS ARE STANDARD
           RECORD CONTAINS 350 CHARACTERS.
       01  CUSTOMER-EXTRACT-REC.
           05  CUST-ID          PIC 9(10).        *> Bytes 1-10
           05  CUST-NAME        PIC X(40).        *> Bytes 11-50
           05  CUST-BALANCE     PIC S9(11)V99 COMP-3. *> Bytes 51-57 (packed)
           05  CUST-STATUS-CD   PIC X(2).         *> Bytes 58-59
           05  CUST-OPEN-DATE   PIC 9(8).         *> Bytes 60-67: YYYYMMDD
           05  FILLER           PIC X(283).       *> Bytes 68-350
Hvis COBOL-teamet ændrer sig CUST-BALANCE fra PIC S9(11)V99 COMP-3 til PIC S9(13)V99 COMP-3Ved at tilføje to cifre med præcision for at håndtere større saldoværdier udvides feltet fra 7 bytes til 8 bytes i pakket decimalformat. Hvert felt efter byte 50 flyttes én position. Den flade fil, som ETL-pipelinen læser, har nu alle felter efter CUST-BALANCE på de forkerte bytepositioner. ETL-pipelinen producerer ikke en fejl; den læser bytes 51-57 som CUST-BALANCE og fortolker den næste byte (som nu er den første byte i CUST-BALANCEs udvidede repræsentation) som en del af CUST-STATUS-CD. Pipelinen kører. Tallene er forkerte. Ingen skemadrift-advarsel udløses.
Dette er den farligste klasse af skemadrift i virksomhedsmiljøer: strukturelle ændringer i ældre systemer, der spredes lydløst gennem flade filgrænseflader uden nogen detektionsmekanisme i nogen af enderne.
Tre egenskaber gør forskydning af ældre grænser unikt farlig:
Skemaet er usynligt for observationsværktøjer. Monte Carlo kan ikke oprette forbindelse til en VSAM-fil. Acceldata kan ikke forespørge på en FD-post. Den eneste måde at registrere ændringen på er at sammenligne COBOL-kilden med en tidligere version, en kodeanalyseoperation, ikke en dataovervågningsoperation.
Udbredelsen er lydløs. Flade filgrænseflader validerer ikke poststrukturen; de læser bytes. En ændring af bytelayoutet producerer forkerte værdier, ikke fejl.
Sprængningsradiusen er bred. En COBOL-kopibog, der er inkluderet i 300 programmer, er et skema, der deles af 300 programmer. En ændring i kopibogen, svarende til en DDL ALTER TABLE, påvirker alle 300 samtidigt, og enhver downstream-forbruger af ethvert datasæt produceret af et af disse 300 programmer arver driften.
Skemakontrakter: Formalisering af det, der normalt er implicit
Den strukturelle løsning på skemadrift er at gøre implicitte kontrakter eksplicitte ved at definere, hvad skemaet er, hvem der er afhængig af det, og hvilke ændringer der er tilladt, før en ændring foretages, snarere end efter den ødelægger noget.
| Kontraktlag | Hvad det styrer | Værktøjer | Ækvivalent til ældre |
|---|---|---|---|
| Database DDL | Tabelstruktur, kolonnetyper, begrænsninger | Liquibase, Flyway, Atlas | DB2 DDL-migreringsscripts |
| Hændelsesskema | Kafka/event stream-struktur | Konfluent Schema Registry, Apicurio | Ikke tilgængelig (flad fil har ingen registreringsdatabase) |
| API-kontrakt | Forventninger til REST/gRPC-grænsefladen | OpenAPI, Pact, AsyncAPI | Ikke tilgængelig (filgrænsefladen har ingen specifikation) |
| Datakvalitet | Værdifordelinger, friskhed, volumen | Store forventninger, dbt-tests | Ikke tilgængelig (intet native testframework) |
| Filformatkontrakt | Flad filbytelayout, feltpositioner | COBOL FD-post (sandhedskilde) | Versionskontrol af kopibog |
Posten "Versionskontrol af kopibog" i den tilsvarende kolonne for ældre versioner er den praktiske mekanisme til at styre COBOL-skemaudvikling: kopibogen behandles som et versionsbaseret artefakt med en ændringsgodkendelsesproces, der vedligeholdes et register over, hvilke programmer der inkluderer hver kopibog, og der kræves en konsekvensanalyse, før enhver ændring af kopibogen godkendes.
En arbejdsgang til godkendelse af ændringer i kopibog:
- Udvikleren foreslår en ændring af
CUSTMSTR.CPY - Effektanalyse identificerer hvert program, der inkluderer
CUSTMSTR.CPY(statisk analyse) - Enhver flad fil produceret af disse programmer identificeres som en skemaændringshændelse
- Enhver downstream-forbruger af disse flade filer underrettes
- Forbrugervalideringstests køres mod det nye layout
- Ændringen er kun godkendt, når alle forbrugere bekræfter kompatibiliteten
Denne arbejdsgang afspejler håndhævelsesmønsteret for kompatibilitet med skemaregistret, der anvendes på COBOL-laget, hvor der ikke findes et native skemaregister.
Overvågningsarkitektur for distribueret skemadrift
En komplet arkitektur for overvågning af skemadrift dækker alle fire drifttyper på tværs af alle systemlag:
Schema-snapshot-database. Gem et dagligt snapshot af hver tabels INFORMATION_SCHEMA-metadata, hver registreret hændelsesskemaversion, hver API-specifikationsversion og (for ældre systemer) hver kopibogsversion. Snapshot-databasen er den baseline, som den aktuelle tilstand sammenlignes med.
Ændringsdetekteringspipeline. Daglige sammenligningsjob kører mod snapshot-databasen og registrerer tilføjelser, fjernelser, typeændringer og begrænsningsændringer på hvert overvåget lag. Ændringer med høj alvorlighedsgrad, ikke-bagudkompatible typeændringer, fjernelse af kolonner, tilføjelser af obligatoriske felter udløser øjeblikkelige advarsler. Ændringer med lav alvorlighedsgrad, tilføjelser af kolonner, der kan indeholde nuller, indeksændringer genererer rådgivende meddelelser.
Forbrugerpåvirkningsregister. Et katalog, der knytter alle skemaartefakter til dets kendte forbrugere: hvilke pipelines læser fra hvilke tabeller, hvilke tjenester forbruger hvilke Kafka-emner, hvilke ETL-job behandler hvilke flade filer. Når en skemaændring registreres, bestemmer forbrugerpåvirkningsregisteret eksplosionsradius, hvor mange forbrugere der er berørt, og hvilke der er mest kritiske.
Kontrakttestsuite. Automatiserede tests, der verificerer forbrugernes antagelser om producentskemaer. Kør på alle implementeringer, der berører en dataproducerende tjeneste. Mislykkes implementeringen, hvis en kontrakt, som en registreret forbruger er afhængig af, overtrædes.
Overvågning af ældre grænser. For mainframe-systemer: versionsstyret kopbogssammenligning, overvågning af JCL-datasætdefinitioner og validering af fladt filformat mod det skema, der er defineret i det producerende programs FD-post. Dette lag kræver kodeanalyse snarere end dataovervågning, hvor ændringer i COBOL-kilden registreres, som udgør skemaændringer for downstream-forbrugere.
Planlagt overvågning er vigtigere, end mange teams antager. Acceldatas vejledning om planlagt driftanalyse anbefaler automatiserede sammenligninger mod en stabil baseline på en ugentlig eller hver anden ugentlig kadence, og bemærker eksplicit, at det ikke er tilstrækkeligt at vente på ad hoc-kontroller efter fejl. Specifikt for overvågning af ældre grænser bør kadencen matche COBOL-implementeringsplanen: enhver kopibogsfrigivelse til produktion bør udløse en øjeblikkelig skemapåvirkningsanalyse i stedet for at vente på den næste planlagte sammenligning.
Hvordan SMART TS XL Adresserer skemadrift i ældre miljøer
SMART TS XL adresserer detektionskløften ved det ældre systems grænse, det lag hvor moderne observerbarhedsværktøjer stopper, og hvor den farligste skemaafvigelse forbliver uopdaget.
Funktionen til statisk kodeanalyse analyserer alle COBOL FD-poster, COPY-medlemmer og SELECT-klausuler for at producere en struktureret repræsentation af alle skemaartefakter i det ældre miljø. Når denne analyse køres mod to versioner af kodebasen, før og efter en implementering, udgør forskellene ændringsloggen for det ældre skema: hvilke kopibøger der blev ændret, hvilke feltdefinitioner der blev ændret, og hvad før- og efter-layoutene var. Dette er den skema-snapshot-sammenligning, der anvendes på COBOL-laget.
Programafhængighedskortlægningen leverer forbrugerpåvirkningsregistret for ældre skemaer: hvilke programmer, der inkluderer hver kopibog, hvilke programmer, der producerer hvilke flade fildatasæt, hvilke JCL-job, der kalder hvilke programmer. Når skemaændringsloggen identificerer en ændret kopibog, producerer afhængighedskortet straks forbrugerlisten, hvert program, der inkluderer kopibogen, og hver downstream-flad fil, som disse programmer producerer. Dette er eksplosionsradiusberegningen, der afgør, om en ændring af kopibogen er en intern ændring med lav risiko eller en højrisikohændelse, der påvirker hundredvis af programmer og snesevis af downstream-forbrugere.
Effektanalysefunktionen konverterer sprængningsradiusen til et struktureret afhjælpningsområde: Hvilke ændringer er nødvendige for hver forbruger , der er identificeret af afhængighedskortet, for at imødekomme det nye skema, og i hvilken rækkefølge skal disse ændringer anvendes? For ældre til moderne grænseforbrugere, ETL-pipelines, der læser flade filer produceret af COBOL-programmer, identificerer effektanalysen de specifikke feltpositionsændringer og datatypeændringer, som ETL-pipelinens kolonnekortlægningskonfiguration skal opdateres for at afspejle.
Virksomhedssøgningsfunktionen gør det muligt at forespørge på opdagelse af skemaartefakter: find alle programmer, der læser et felt på en bestemt byteposition (identificerer forbrugere , der vil blive påvirket af en layoutændring), alle kopibøger, der definerer et specifikt felt (identificerer den skemaartefakt, der skal versionskontrolleres og ændres), og alle programmer, der producerer output til et specifikt datasæt (identificerer de producenter, hvis skemaændringer skal udløse forbrugernotifikationer). Denne søgefunktion understøtter både den proaktive skemastyringsworkflow og undersøgelsen af hændelser efter drift.
For organisationer, der administrerer arvemodernisering programmer, der omfatter migrering af mainframe-data til moderne platforme, SMART TS XL's skemaanalyse leverer den kildeskemadokumentation, som migreringsværktøjer kræver, de komplette, aktuelle FD-postdefinitioner og kopibogsstrukturer, der definerer, hvad dataene faktisk er, ikke kun hvad de var, da den oprindelige migreringsspecifikation blev skrevet.
Kontrakten ingen skrev er stadig en kontrakt
Schema-drift i distribuerede systemer er ikke et nyt problem. Det er et gammelt problem, som distribueret arkitektur gør det sværere at løse, fordi den autoritet, der håndhævede skema-kontrakter i monolitiske systemer, den centrale databaseadministrator, det enkelte applikationsteam, den samlede kodebase, er blevet distribueret på tværs af snesevis af uafhængige tjenester, der hver især træffer individuelt fornuftige beslutninger med ufuldstændig indsigt i hver enkelt downstream-forbruger.
Løsningen er ikke at recentralisere autoriteten over skemaer. Det er at gøre de implicitte kontrakter eksplicitte, registrere dem i systemer, der kan sammenligne den nuværende tilstand med baseline, håndhæve kompatibilitetsregler ved de grænser, hvor ændringer introduceres, og overvåge overtrædelser ved de grænser, hvor ændringer udbredes. For moderne systemer findes værktøjerne til dette, og de forbedres hurtigt. For ældre systemer på grænsen til moderne platforme er værktøjskløften reel og afgørende. Det flade filformat, der er en skemakontrakt for en cloud-ETL-pipeline, er usynligt for alle moderne observerbarhedsværktøjer, medmindre COBOL-kilden, der definerer den, analyseres og versioneres som en skemaartefakt.
Dashboardet, der viste et fald på 23 procent i kundeanskaffelse, tog ikke fejl med hensyn til de data, det modtog. Det tog fejl med hensyn til, hvad dataene betød, fordi det skema, der definerede dataenes betydning, havde ændret sig ved en grænse, hvor der ikke var registreret nogen kontrakt, og ingen overvåger holdt øje. Denne grænse, uanset hvor den findes i et distribueret system, ældre eller moderne, er der, hvor programmer til detektion af skemadrift skal nå.
