
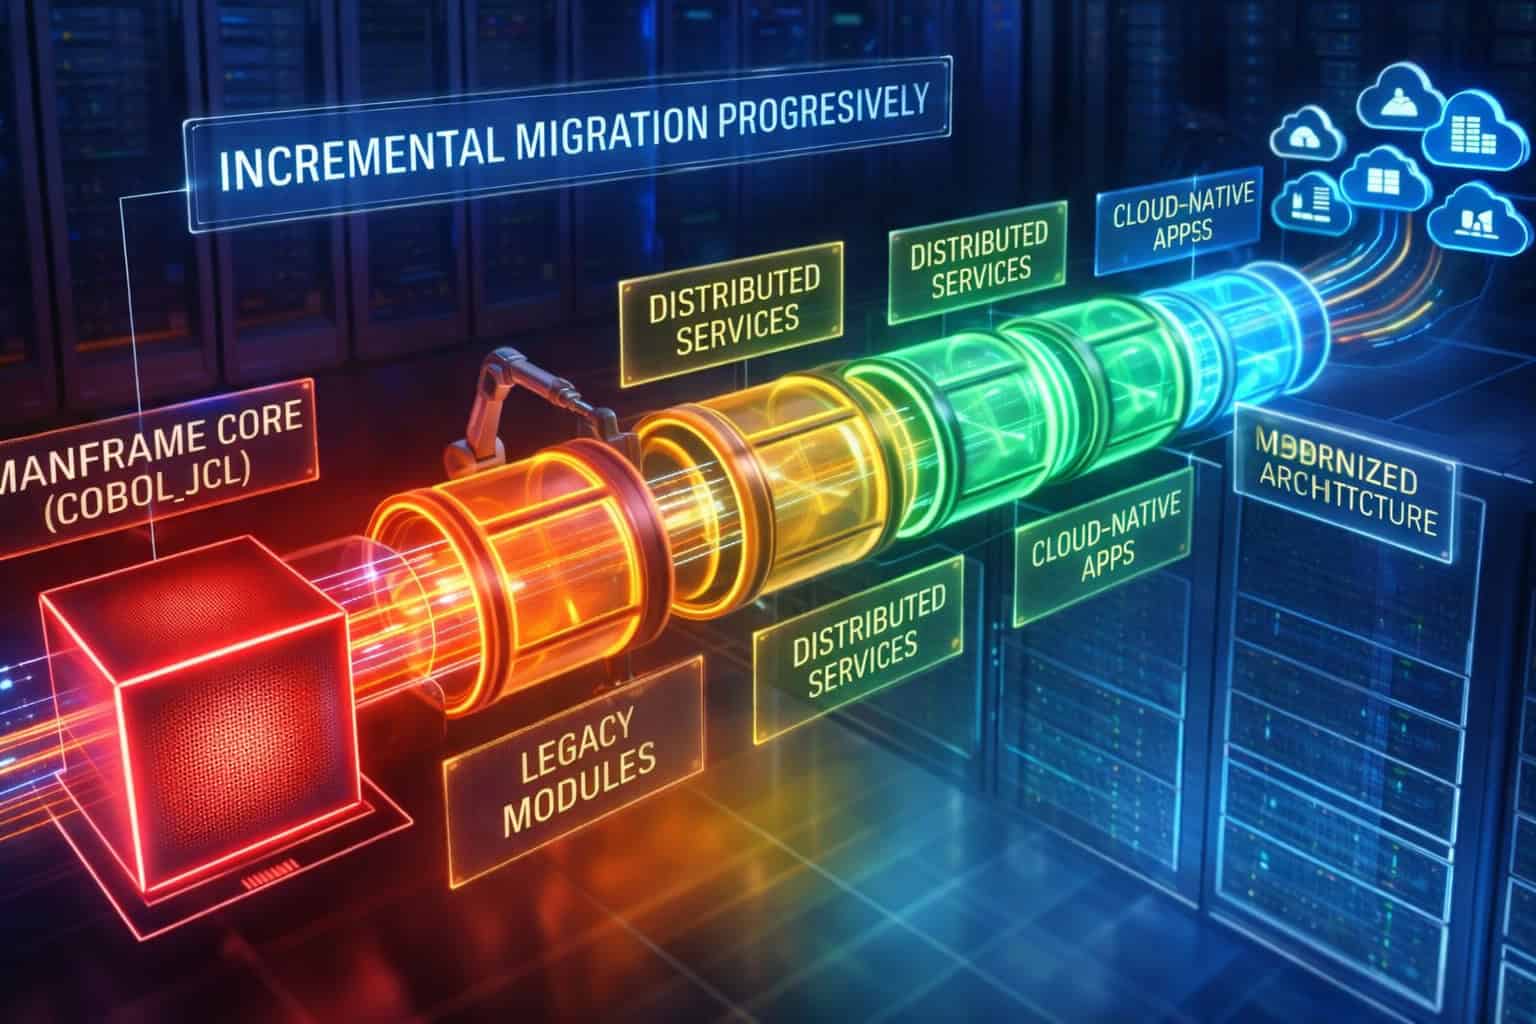
Przyrostowa migracja komputerów mainframe stała się dominującą strategią dla przedsiębiorstw, które chcą modernizować się bez zakłócania operacji o znaczeniu krytycznym. Zamiast podejmować próby całkowitego przepisania oprogramowania lub ryzykownych przełączeń, organizacje coraz częściej decydują się na stopniową transformację obejmującą programy COBOL, przepływy pracy JCL i usługi rozproszone. To podejście odzwierciedla rzeczywistość operacyjną dużych systemów, gdzie systemy muszą stale przetwarzać transakcje, rozliczać partie i spełniać wymogi regulacyjne przez cały proces migracji.
Pomimo swojej atrakcyjności, migracja przyrostowa wprowadza unikalną klasę złożoności technicznej. Logika COBOL, orkiestracja JCL i rozproszone środowiska wykonawcze rzadko były projektowane z myślą o niezależnej ewolucji. Przez dekady przepływ wykonywania, synchronizacja danych i obsługa awarii stały się ściśle powiązane na tych warstwach. Gdy inicjatywy migracyjne próbują wyodrębnić lub zmodernizować jeden element na raz, ukryte powiązania ujawniają się w nieoczekiwany sposób, spowalniając postęp i zwiększając ryzyko operacyjne. Wyzwania te są spotęgowane w środowiskach, które już borykają się z przestarzałymi metodami modernizacji systemów , gdzie dokumentacja nie odzwierciedla już rzeczywistego działania systemu.
Kontrola wpływu migracji
Rozwiązanie Smart TS XL pomaga organizacjom zachować ciągłość działania przy stopniowej migracji starszych obciążeń.
Przeglądaj terazNajtrudniejsze problemy rzadko pojawiają się na poziomie pojedynczych programów lub usług. Zamiast tego, pojawiają się na granicy między przetwarzaniem wsadowym a przetwarzaniem online, między zaplanowanym wykonywaniem a przepływami sterowanymi zdarzeniami oraz między deterministyczną logiką komputerów mainframe a rozproszoną semantyką ponawiania prób. Działania związane z migracją przyrostową często utykają w martwym punkcie, gdy te granice zostaną przekroczone bez jasnego zrozumienia ścieżek wykonywania i zależności danych. To, co wydaje się ograniczoną zmianą, może rozprzestrzeniać się na różne platformy, zmuszając zespoły do długotrwałych cyklów stabilizacji zamiast stałej transformacji.
Pomyślna migracja między językami COBOL, JCL i usługami rozproszonymi wymaga zatem czegoś więcej niż tylko narzędzi czy wzorców migracji. Wymaga ona precyzyjnego zrozumienia, jak obecnie działają systemy, jak dzielone są obowiązki między komponentami oraz jak zmienia się zachowanie, gdy części systemu przemieszczają się niezależnie. W miarę jak przedsiębiorstwa realizują strategie stopniowej modernizacji , zdolność do wnioskowania o ciągłości wykonywania, integralności przepływu danych i semantyce awarii staje się czynnikiem decydującym o tym, czy postęp jest kontrolowany, czy transformacja stoi w miejscu.
Powiązanie strukturalne między programami COBOL i przepływami pracy JCL
Przyrostowa migracja komputerów mainframe często nie docenia stopnia, w jakim programy COBOL i przepływy pracy JCL są strukturalnie nierozerwalne. Chociaż często są zarządzane jako odrębne artefakty, ich semantyka wykonania ewoluowała razem przez dekady. JCL oferuje znacznie więcej niż tylko harmonogramowanie programów. Definiuje kolejność wykonywania, rozgałęzienia warunkowe, zachowanie restartu, cykle życia zbiorów danych i semantykę odzyskiwania, na których domyślnie opiera się kod COBOL. Niezależne traktowanie tych elementów podczas migracji wprowadza ryzyko, które nie jest od razu widoczne na poziomie kodu.
To powiązanie staje się szczególnie problematyczne, gdy inicjatywy migracyjne koncentrują się na wyodrębnianiu lub modernizacji logiki COBOL-a bez uwzględnienia jej kontekstu operacyjnego. Zachowanie programu w izolacji rzadko odpowiada jego zachowaniu w strumieniu zadań produkcyjnych. Migracja przyrostowa, która ignoruje tę zależność, często prowadzi do dryfu funkcjonalnego, niespójnych stanów danych i wydłużonych cykli stabilizacji, co niweczy korzyści płynące z transformacji fazowej.
JCL jako warstwa kontroli wykonania, a nie tylko logika harmonogramowania
JCL jest często błędnie przedstawiany jako mechanizm planowania lub orkiestracji, którego główną rolą jest sekwencyjne wywoływanie programów. W rzeczywistości JCL funkcjonuje jako warstwa sterowania wykonywaniem, która definiuje, jak i kiedy programy COBOL są uruchamiane, w jakich warunkach się rozgałęziają oraz jak reagują na stany sukcesu i niepowodzenia. Instrukcje warunkowe, sprawdzanie kodu zwrotnego i reguły dyspozycji zbiorów danych kodują logikę biznesową i operacyjną, która jest zewnętrzna wobec samego programu.
Podczas stopniowej migracji programów COBOL bez powiązanego z nimi kontekstu JCL, ta logika sterowania jest często reimplementowana niejawnie lub całkowicie pomijana. W rezultacie zachowanie programu subtelnie odbiega od norm produkcyjnych. Program, który wydaje się funkcjonalnie poprawny w izolacji, może być wykonywany w innych warunkach, przetwarzać inne zakresy danych lub nie wywoływać kolejnych kroków w oczekiwanym momencie.
Problem ten pogłębia się w środowiskach, w których JCL nagromadził warstwowe warunki z biegiem czasu. Awaryjne poprawki, wyjątki regulacyjne i zabezpieczenia operacyjne są często kodowane bezpośrednio w strumieniach zadań, a nie w logice aplikacji. Konstrukcje te mogą być aktywowane tylko w określonych okolicznościach, przez co łatwo je przeoczyć podczas analizy. Bez wglądu w tę warstwę kontroli zespoły ds. migracji ryzykują utratę zachowań kluczowych dla stabilności produkcji.
Zrozumienie JCL jako mechanizmu kontroli wykonania jest zatem kluczowe dla bezpiecznej migracji przyrostowej. Gwarantuje to, że działania modernizacyjne zachowają nie tylko rezultaty funkcjonalne, ale także semantykę operacyjną, która decyduje o tym, kiedy i jak te rezultaty są generowane.
Warunkowe przepływy pracy i ich wpływ na granice migracji
Warunkowe przepływy zadań stanowią jedną z najpoważniejszych barier dla czystych granic migracji. W wielu środowiskach mainframe ścieżki wykonania różnią się w zależności od kodów powrotu, dostępności zestawu danych lub sygnałów zewnętrznych. Warunki te decydują o tym, które programy zostaną uruchomione, które kroki zostaną pominięte i jak dane będą obsługiwane w całym strumieniu zadań.
Migracje przyrostowe często zakładają liniowe modele wykonywania, które nie odzwierciedlają tej rzeczywistości. Gdy program COBOL jest ekstrahowany lub rehostowany bez uwzględnienia warunkowego przepływu zadań, migrowany komponent może być uruchamiany częściej lub w innych okolicznościach niż zamierzono. Ta rozbieżność stwarza ryzyko naruszenia integralności danych i nieprzewidywalnego zachowania operacyjnego.
Przepływy warunkowe komplikują również proces wycofywania i odzyskiwania. W tradycyjnych środowiskach warunki JCL definiują punkty restartu i sposób kompensacji. Gdy część przepływu jest migrowana, a część pozostaje na komputerze mainframe, utrzymanie spójnej semantyki restartu staje się trudne. Zespoły mogą odkryć, że procedury odzyskiwania nie są już spójne na różnych platformach, co zwiększa ryzyko operacyjne podczas incydentów.
Te problemy podkreślają wagę analizy struktury przepływu zadań przed zdefiniowaniem granic migracji. Ścieżki wykonywania warunkowego muszą zostać zidentyfikowane i zachowane, aby zapewnić ciągłość działania. To wyzwanie jest ściśle powiązane z zagadnieniami omawianymi w rozdziale poświęconym mapowaniu JCL , gdzie zrozumienie kontekstu wywołania programu okazuje się kluczowe dla dokładnego zrozumienia systemu.
Cykle życia zbiorów danych jako niejawne mechanizmy sprzęgania
Poza przepływem sterowania, zbiory danych tworzą kolejną warstwę niejawnego sprzężenia między programami COBOL a przepływami pracy JCL. JCL definiuje reguły tworzenia, przechowywania, udostępniania i usuwania zbiorów danych, które regulują sposób przepływu danych w strumieniu zadań. Programy COBOL często domyślnie przyjmują te reguły, polegając na JCL w zarządzaniu dostępnością i cyklem życia danych.
Podczas migracji przyrostowej obsługa zbiorów danych jest często reinterpretowana lub abstrakcyjna bez pełnego odtworzenia oryginalnej semantyki. Tymczasowe zbiory danych mogą stać się trwałe, współdzielone zbiory danych mogą zostać zduplikowane, a logika czyszczenia może ulec zmianie. Zmiany te mogą mieć kaskadowy wpływ na dalsze przetwarzanie i spójność danych.
Problem polega na tym, że cykle życia zbiorów danych rzadko są dokumentowane w sposób scentralizowany. Są one kodowane w wielu etapach pracy i wzmacniane za pomocą konwencji operacyjnych. Zespoły migracyjne, które koncentrują się wyłącznie na analizie na poziomie kodu, mogą przeoczyć te zależności, co prowadzi do subtelnych, ale znaczących odchyleń.
Zachowanie semantyki zbioru danych wymaga zrozumienia, jak dane przepływają przez strumienie zadań i jak reguły cyklu życia wpływają na wykonanie. Bez tego zrozumienia, migracja przyrostowa grozi pojawieniem się ukrytych problemów ze sprzężeniem danych, które ujawniają się dopiero w warunkach obciążenia lub awarii.
Semantyka ponownego uruchamiania i odzyskiwania wbudowana w projekt zadania
Restart i odzyskiwanie w środowiskach mainframe jest często osadzone bezpośrednio w projekcie zadania, a nie w logice aplikacji. Parametry restartu JCL, konwencje punktów kontrolnych i logika ponownego uruchamiania warunkowego definiują sposób odzyskiwania systemów po częściowych awariach. Programy COBOL są pisane z uwzględnieniem tych mechanizmów, zakładając pewne gwarancje ponownego uruchomienia.
Gdy działania migracyjne oddzielają programy od ich kontekstu pracy, założenia te mogą przestać obowiązywać. Zmigrowany komponent może nie mieć odpowiedniej semantyki ponownego uruchomienia, co zmusza zespoły do przeprojektowania procedur odzyskiwania lub akceptacji zwiększonego ryzyka. Ten wysiłek związany z przeprojektowaniem jest często niedoceniany i staje się przyczyną opóźnień w programach migracji przyrostowej.
Utrzymanie spójnego działania odzyskiwania danych w różnych fazach migracji ma kluczowe znaczenie dla stabilności operacyjnej. Zapewnia przewidywalność obsługi awarii nawet podczas przenoszenia komponentów między platformami. Kwestia ta jest ściśle powiązana z szerszymi wyzwaniami związanymi z zarządzaniem okresami równoległego wykonywania zadań , gdzie spójność odzyskiwania danych jest czynnikiem decydującym o sukcesie.
Strukturalne powiązanie między językami COBOL i JCL nie stanowi zatem przeszkody dla migracji, lecz jest rzeczywistością, którą należy wyraźnie uwzględnić. Migracja przyrostowa jest skuteczna, gdy relacje te są zrozumiane, respektowane i świadomie zachowywane w różnych fazach transformacji.
Dlaczego migracja przyrostowa jest przerywana na granicy wsadowej i online
Granica między przetwarzaniem wsadowym a systemami transakcyjnymi online jest jednym z najbardziej kruchych punktów w przyrostowej migracji komputerów mainframe. Chociaż obciążenia wsadowe i online są często omawiane jako oddzielne domeny, w dojrzałych środowiskach korporacyjnych działają one jako ściśle skoordynowany system. Zadania wsadowe przygotowują, agregują i uzgadniają dane pobierane przez systemy online w czasie niemal rzeczywistym. Migracje przyrostowe, które traktują te domeny niezależnie, często napotykają na niestabilność, gdy czas wykonania, dostępność danych lub obsługa awarii różnią się.
Ta kruchość jest spotęgowana w architekturach hybrydowych, gdzie części potoku przetwarzania wsadowego pozostają na komputerach mainframe, podczas gdy usługi online są stopniowo przenoszone na platformy rozproszone. Założenia, które przez dekady rządziły koordynacją przetwarzania wsadowego online, przestają obowiązywać, gdy wykonywanie obejmuje wiele środowisk wykonawczych. Bez precyzyjnego zrozumienia, jak dane wyjściowe przetwarzania wsadowego są zgodne z oczekiwaniami online, inicjatywy migracyjne utknęły na tym poziomie, nie z powodu technicznej niemożności, ale z powodu niepewności behawioralnej.
Zależności czasowe między ukończeniem partii a dostępnością online
Jednym z najbardziej niedocenianych wyzwań migracji przyrostowej jest występowanie zależności czasowych między wykonywaniem zadań wsadowych a dostępnością systemu online. Wiele aplikacji online zakłada, że określone cykle zadań wsadowych zostały pomyślnie ukończone przed przetworzeniem transakcji. Założenia te rzadko są egzekwowane za pomocą jawnych mechanizmów synchronizacji. Zamiast tego są one osadzone w harmonogramach operacyjnych, terminach granicznych i nieformalnych podręcznikach.
Podczas stopniowej migracji obciążeń wsadowych, czas wykonania często ulega zmianie. Rozproszone struktury wsadowe mogą działać szybciej, wolniej lub z inną semantyką ponawiania prób niż ich odpowiedniki na komputerach mainframe. Nawet niewielkie zmiany w czasie wykonania mogą narazić systemy online na częściowo przygotowane zbiory danych, co prowadzi do niespójnego zachowania, trudnego do zdiagnozowania.
Te problemy z synchronizacją są szczególnie problematyczne podczas migracji fazowej, gdzie niektóre kroki wsadowe są wykonywane na komputerach mainframe, a inne na platformach rozproszonych. Systemy online mogą napotkać mieszane stany, które nigdy nie występowały w pierwotnym środowisku. Procedury odzyskiwania, które kiedyś opierały się na przewidywalnych oknach wsadowych, stają się zawodne, co zwiększa ryzyko operacyjne.
Zrozumienie i zachowanie zależności czasowych jest kluczowe dla utrzymania stabilności w obrębie granic przetwarzania wsadowego online. Bez wyraźnego modelowania tych relacji, migracja przyrostowa wprowadza subtelne sytuacje wyścigowe, które pojawiają się dopiero w scenariuszach obciążenia lub awarii.
Oczekiwania dotyczące spójności danych osadzone w logice online
Aplikacje online często kodują niejawne założenia dotyczące spójności danych, wynikające z przetwarzania wsadowego. Na przykład transakcje online mogą zakładać, że tabele referencyjne są w pełni odświeżane, salda uzgadniane, a agregacje zakończone przed rozpoczęciem aktywności użytkownika. Założenia te rzadko są weryfikowane dynamicznie, ponieważ historycznie były gwarantowane przez kolejność wykonywania wsadowego.
Migracja przyrostowa zaburza te gwarancje. Gdy kroki wsadowe są przenoszone lub ponownie implementowane, model spójności może ulec zmianie. Systemy rozproszone mogą ujawniać stany pośrednie, które wcześniej były ukryte, lub stosować spójność końcową tam, gdzie zakładano silną spójność. Logika online, która nigdy nie została zaprojektowana do obsługi takich stanów, zaczyna wykazywać nieprzewidywalne zachowanie.
Ta rozbieżność tworzy pętlę sprzężenia zwrotnego, która komplikuje migrację. Awarie online uruchamiają dochodzenie w procesach wsadowych, a zmiany w procesach wsadowych są ograniczone przez wymagania dotyczące stabilności online. Zespoły migracyjne nie są w stanie kontynuować pracy bez zamrożenia jednej strony granicy, co podważa podejście przyrostowe.
Rozwiązanie tego problemu wymaga wyraźnego określenia założeń dotyczących spójności danych. Działania migracyjne muszą identyfikować, które dane wyjściowe wsadowe są krytyczne dla poprawności online i zapewniać zachowanie równoważnych gwarancji. Problem ten jest ściśle powiązany z wyzwaniami omawianymi w strategiach przyrostowej migracji danych , gdzie częściowe przenoszenie danych stwarza ryzyko spójności.
Propagacja błędów w domenach wsadowych i online
Awarie, które przekraczają granicę przetwarzania wsadowego online, są szczególnie trudne do wyizolowania podczas migracji przyrostowej. Awaria przetwarzania wsadowego może ujawnić się kilka godzin później jako problem z przetwarzaniem online, a przeciążenie online może spowodować opóźnienia przetwarzania wsadowego z powodu współdzielonych zasobów. W środowiskach hybrydowych śledzenie tych interakcji staje się trudniejsze, ponieważ komponenty obejmują wiele platform.
Migracja przyrostowa zwiększa liczbę ścieżek awarii poprzez wprowadzenie nowych punktów integracji i kontekstów wykonania. Awaria w zmigrowanym kroku wsadowym może rozprzestrzeniać się inaczej niż w środowisku pierwotnym, wywołując objawy online, które nie odpowiadają historycznym wzorcom. Zespoły odzyskiwania danych mają trudności z ustaleniem, czy problemy wynikają z zmigrowanych komponentów, czy ze starszych, co spowalnia rozwiązywanie problemów.
Brak jednolitej widoczności wykonania w domenach wsadowych i online pogłębia ten problem. Narzędzia monitorujące często koncentrują się na jednej lub drugiej domenie, pozostawiając luki na granicy. Podczas incydentów zespoły muszą ręcznie korelować sygnały, co zwiększa MTTR i wariancję odzyskiwania.
Zrozumienie propagacji awarii wymaga analizy interakcji systemów wsadowych i online zarówno w warunkach normalnych, jak i nadzwyczajnych. Bez tej analizy migracja przyrostowa wprowadza nowe martwe punkty operacyjne, które wpływają negatywnie na stabilność.
Przyrostowa złożoność przełączania w interfejsie Batch Online
Stopniowe przenoszenie funkcjonalności na granicy przetwarzania wsadowego online wprowadza własną złożoność. Plany migracji często zakładają, że komponenty można przełączać niezależnie. W praktyce przenoszenie systemów wsadowych i online musi odbywać się w skoordynowanych fazach, aby zachować integralność działania.
Częściowe przełączenia tworzą hybrydowe ścieżki realizacji, w których niektóre transakcje opierają się na zmigrowanych danych wsadowych, a inne na starszym przetwarzaniu. Te mieszane stany są trudne do kompleksowego przetestowania i często ujawniają problemy dopiero w środowisku produkcyjnym. Procedury wycofywania stają się skomplikowane, ponieważ odwrócenie jednej strony granicy może nie przywrócić pierwotnego zachowania.
Ta złożoność zmusza organizacje do stosowania konserwatywnych strategii przejścia, które spowalniają postęp migracji. Zespoły opóźniają przejścia do momentu, aż upewnią się, że wszystkie interakcje są zrozumiałe, co zmniejsza korzyści płynące ze zwinności migracji stopniowej.
Rozwiązanie problemu złożoności przełączenia wymaga precyzyjnej wiedzy na temat interakcji wsadowych online i ich zależności. Wnioski podobne do tych opisanych w artykule o wyzwaniach związanych z modernizacją obciążeń wsadowych podkreślają potrzebę starannego ustalania kolejności i świadomości wpływu.
Migracja przyrostowa sprawdza się na granicy wsadu online, gdy czas wykonania, spójność danych, propagacja błędów i sekwencja przełączania są rozumiane i zarządzane jako spójny system, a nie jako odizolowane kwestie.
Zarządzanie ciągłością ścieżki wykonywania podczas ekstrakcji COBOL
Przyrostowa ekstrakcja kodu COBOL jest często przedstawiana jako ćwiczenie skoncentrowane na kodzie, jednak jej prawdziwa złożoność polega na zachowaniu ciągłości ścieżki wykonania podczas przenoszenia komponentów między platformami. Programy COBOL rzadko działają jako odizolowane jednostki. Ich zachowanie jest kształtowane przez kontekst wywołania, wstępne przygotowanie danych, późniejsze wykorzystanie oraz warunki środowiskowe, które łącznie definiują przebieg wykonania w środowisku produkcyjnym. Gdy działania związane z ekstrakcją koncentrują się wąsko na logice programu, te czynniki kontekstowe łatwo przeoczane.
Ciągłość ścieżki wykonania ma kluczowe znaczenie, ponieważ decyduje o tym, czy migrowane komponenty zachowują się spójnie z ich starszymi odpowiednikami. Nawet niewielkie odchylenia w przepływie sterowania, czasie wywołań lub obsłudze danych mogą powodować subtelne odchylenia behawioralne. W dużych przedsiębiorstwach takie odchylenia kumulują się na różnych etapach migracji, prowadząc do nieprzewidywalnego zachowania systemu, co spowalnia postęp i podważa zaufanie do podejścia przyrostowego.
Zachowanie wierności logiki warunkowej w różnych fazach migracji
Logika warunkowa osadzona w programach COBOL często odzwierciedla dekady wyjątków biznesowych, dostosowań regulacyjnych i zabezpieczeń operacyjnych. Warunki te mogą zależeć od wartości danych, kontekstu wykonania lub sygnałów zewnętrznych, które nie są od razu oczywiste podczas ekstrakcji. Zachowanie ich wierności jest kluczowe dla utrzymania ciągłości wykonywania.
Podczas migracji przyrostowej logika warunkowa jest często reinterpretowana lub refaktoryzowana w celu dostosowania do nowych platform lub frameworków. Chociaż taka refaktoryzacja może poprawić czytelność lub wydajność, istnieje ryzyko zmiany sposobu wykonywania, jeśli nie jest oparta na dogłębnym zrozumieniu pierwotnych warunków. Logika, która została zaprojektowana do wykonywania tylko w rzadkich przypadkach, może stać się częstsza lub odwrotnie, zmieniając wyniki systemu.
Ryzyko to jest spotęgowane, gdy zachowanie warunkowe obejmuje wiele programów. Warunek oceniany w jednym module COBOL może pośrednio wpływać na dalsze ścieżki wykonywania poprzez zmiany danych lub kody powrotu. Wyodrębnienie pojedynczego programu bez modelowania tych interakcji może złamać niejawne kontrakty regulujące przepływ wykonywania.
Radzenie sobie z tym wyzwaniem wymaga identyfikacji logiki warunkowej nie tylko w obrębie programów, ale także w różnych ścieżkach wykonania. Zespoły muszą zrozumieć, kiedy warunki się aktywują, jak często występują i jakie skutki wywołują. Bez tego zrozumienia, ekstrakcja przyrostowa wprowadza rozbieżności w zachowaniach, które trudno wykryć wyłącznie poprzez testowanie.
Zmiany kontekstu wywołania i ich ukryte skutki
Programy COBOL są wrażliwe na sposób ich wywołania. Parametry, środowisko wykonawcze i kontekst wywołania wpływają na działanie programu w sposób, który często nie jest udokumentowany. Ekstrakcja przyrostowa często zmienia mechanizmy wywołań, zastępując wykonywanie sterowane przez JCL wywołaniami usług, harmonogramami lub rozproszonymi strukturami zadań.
Te zmiany mogą subtelnie modyfikować ścieżki wykonywania. Parametry mogą być przekazywane w inny sposób, wartości domyślne mogą ulec zmianie, a założenia środowiskowe mogą przestać obowiązywać. Na przykład program, który opierał się na niejawnej alokacji zbiorów danych wykonywanej przez JCL, może napotkać brakujące zasoby po wywołaniu w nowym kontekście.
Zmiany kontekstu wywołań wpływają również na obsługę błędów i zachowanie restartu. Programy mogą reagować inaczej na awarie w zależności od sposobu ich wywołania, co wpływa na semantykę odzyskiwania. Różnice te mogą nie ujawnić się aż do wystąpienia incydentów produkcyjnych, w których wycofanie staje się kosztowne.
Zrozumienie kontekstu wywołania jest zatem warunkiem wstępnym bezpiecznej ekstrakcji. Zespoły muszą zmapować, jak programy są obecnie wywoływane, jakie założenia przyjmują i jak te założenia przekładają się na środowisko docelowe. Kwestia ta jest ściśle związana z wyzwaniami opisanymi w technikach wykrywania użycia programu , gdzie kontekst wykonania determinuje rzeczywiste zachowanie systemu.
Zależności kolejności wykonywania między wyodrębnionymi i pozostałymi komponentami
Ekstrakcja przyrostowa tworzy mieszane środowiska wykonawcze, w których niektóre komponenty zostały zmigrowane, a inne pozostają na komputerze mainframe. W takich środowiskach zależności od kolejności wykonywania stają się kwestią krytyczną. Programy COBOL często zakładają, że pewne kroki upstream zostały zakończone i że odbiorcy downstream będą wykonywać się w przewidywalnej kolejności.
Gdy elementy łańcucha wykonawczego poruszają się niezależnie, założenia te mogą przestać obowiązywać. Systemy rozproszone mogą wprowadzać paralelizm lub inną semantykę harmonogramowania, która zaburza ustaloną kolejność. Programy, które kiedyś były wykonywane sekwencyjnie, mogą teraz działać współbieżnie, ujawniając sytuacje wyścigu lub problemy z konfliktami danych.
Te zależności od kolejności rzadko są dokumentowane wprost. Są one egzekwowane poprzez konwencje harmonogramowania i dyscyplinę operacyjną, a nie ograniczenia techniczne. Migracja przyrostowa musi zatem ujawniać i zachowywać te zależności, aby zachować ciągłość wykonywania.
Niedopełnienie tego obowiązku powoduje sporadyczne problemy, które trudno odtworzyć. Systemy mogą wydawać się stabilne przy niewielkim obciążeniu, ale zawodzą w warunkach szczytowych, gdy kolejność wykonywania zadań ulega zmianie. Takie awarie podważają zaufanie do postępu migracji i zmuszają zespoły do wstrzymywania lub cofania zmian.
Dryf behawioralny jako kumulatywne ryzyko migracji
Dryf behawioralny odnosi się do stopniowej rozbieżności między zachowaniem systemu starszego a migrowanego, która występuje w kolejnych fazach migracji. Każda ekstrakcja może wprowadzać drobne zmiany, które wydają się akceptowalne w izolacji, ale z czasem kumulują się, tworząc istotne różnice.
Ten dryft jest szczególnie niebezpieczny, ponieważ często nie jest wykrywany podczas testowania. Testy zazwyczaj weryfikują wyniki funkcjonalne dla konkretnych scenariuszy, a nie dla pełnego spektrum ścieżek wykonania. W rezultacie dryft może pojawić się tylko w rzadkich sytuacjach lub przypadkach skrajnych.
Zarządzanie dryfem behawioralnym wymaga ciągłej walidacji ciągłości działania. Zespoły muszą porównywać nie tylko wyniki, ale także ścieżki działania i punkty decyzyjne w różnych środowiskach. To porównanie pomaga zidentyfikować, gdzie zmienia się zachowanie i czy te zmiany są celowe.
Analiza ścieżki wykonania odgrywa kluczową rolę w tym procesie. Rozumiejąc, jak ścieżki kodu ewoluują wraz z migracją komponentów, organizacje mogą kontrolować dryf i zachować pewność stopniowego postępu. Bez takiej kontroli, działania migracyjne mogą przekształcić się w nieodwracalne eksperymenty, a nie przewidywalne transformacje.
Przyrostowa ekstrakcja kodu COBOL jest skuteczna, gdy ciągłość wykonywania jest traktowana priorytetowo. Zachowanie sposobu działania systemów, a nie tylko ich obliczeń, gwarantuje, że migracja przebiega bez utraty stabilności i zaufania.
Rozproszona integracja usług jako główny mnożnik ryzyka migracji
Usługi rozproszone są często wprowadzane do środowisk mainframe w ramach inicjatyw modernizacyjnych mających na celu zwiększenie elastyczności i skalowalności. Chociaż usługi te umożliwiają stopniową migrację, działają również jako istotny czynnik mnożący ryzyko, jeśli nie są starannie dostosowane do istniejących modeli wykonania. Programy COBOL i przepływy pracy JCL zostały zaprojektowane z myślą o deterministycznym wykonywaniu i ściśle kontrolowanym przesyle danych. Usługi rozproszone natomiast działają w oparciu o zasadniczo inne założenia.
W miarę postępu migracji przyrostowej, współistnienie deterministycznej logiki komputerów mainframe i asynchronicznych usług rozproszonych tworzy napięcia behawioralne. Punkty integracji stają się obszarami, w których rozbieżności w zakresie czasu wykonania, obsługi awarii i spójności danych. Bez świadomej kontroli rozbieżności te zwiększają ryzyko operacyjne i spowalniają postęp migracji, szczególnie gdy usługi są wprowadzane stopniowo wraz ze starszymi komponentami.
Komunikacja asynchroniczna a deterministyczne wykonywanie wsadowe
Jednym z najbardziej wyraźnych kontrastów między usługami rozproszonymi a obciążeniami komputerów mainframe są modele komunikacji. Przetwarzanie wsadowe komputerów mainframe odbywa się zgodnie z deterministycznymi sekwencjami wykonywania, w których kroki są wykonywane w predefiniowanej kolejności, a stany ukończenia są znane. Usługi rozproszone często opierają się na asynchronicznym przesyłaniu komunikatów, gdzie kolejność wykonywania nie jest gwarantowana, a odpowiedzi mogą być opóźnione lub ponawiane.
W przypadku stopniowej integracji usług asynchronicznych założenia osadzone w przepływach pracy wsadowej mogą przestać obowiązywać. Program COBOL może oczekiwać, że proces podrzędny zakończy się przed wykonaniem kolejnego kroku zadania, podczas gdy usługa rozproszona może przetwarzać żądania niezależnie. Ta niezgodność może prowadzić do częściowych aktualizacji, wyścigów danych lub zatrzymywania się przepływów pracy.
Migracja przyrostowa dodatkowo komplikuje sytuację, wprowadzając hybrydowe łańcuchy wykonywania. Niektóre kroki pozostają deterministyczne, podczas gdy inne stają się asynchroniczne, tworząc ścieżki wykonywania, które nigdy nie istniały w pierwotnym systemie. Procedury odzyskiwania zaprojektowane dla przepływów deterministycznych mogą nie uwzględniać komunikatów w trakcie transmisji lub opóźnionego przetwarzania, zwiększając niepewność operacyjną.
Zrozumienie interakcji komunikacji asynchronicznej z wykonywaniem wsadowym ma kluczowe znaczenie dla bezpiecznej migracji. Bez tego zrozumienia usługi rozproszone wprowadzają niedeterminizm, który podważa przewidywalność starszych przepływów pracy.
Semantyka ponawiania prób i jej wpływ na założenia starszej wersji
Usługi rozproszone często wdrażają mechanizmy ponawiania prób w celu zwiększenia odporności. Żądania mogą być ponawiane automatycznie w odpowiedzi na przejściowe awarie, przekroczenia limitu czasu lub problemy z siecią. Choć skuteczne w nowoczesnych systemach, te ponawiania prób mogą naruszać założenia starszych komponentów.
Programy COBOL i przepływy pracy JCL zazwyczaj zakładają pojedyncze wykonanie na wywołanie. Gdy usługa rozproszona ponawia próbę wykonania operacji, która wyzwala przetwarzanie na komputerze mainframe, rezultatem mogą być zduplikowane aktualizacje lub niespójny stan. Problemy te są trudne do wykrycia podczas testowania, ponieważ ponowne próby występują w warunkach awarii, które nie zawsze są symulowane.
Migracja przyrostowa zwiększa narażenie na to ryzyko, ponieważ nowe usługi są wprowadzane obok starej logiki. Zespoły mogą nie zdawać sobie sprawy, że migrowany komponent podlega teraz mechanizmowi ponawiania prób, który wcześniej nie występował. Z czasem może to prowadzić do anomalii danych, które podważają zaufanie do migracji.
Zarządzanie semantyką ponawiania prób wymaga wyraźnej koordynacji między komponentami rozproszonymi i komputerami mainframe. Starsze systemy muszą być chronione przed niezamierzonym ponownym wykonaniem, albo poprzez mechanizmy idempotentności, albo poprzez projektowanie integracyjne. Bez takich środków, ponawianie prób staje się ukrytym multiplikatorem ryzyka.
Wyzwania związane z dryfem schematów i ewolucją kontraktów
Kontrakty danych między systemami rzadko są statyczne, szczególnie w scenariuszach migracji przyrostowej. Usługi rozproszone ewoluują szybko, często wprowadzając zmiany schematu odzwierciedlające nowe wymagania. Starsze systemy są jednak mniej elastyczne i mogą wymagać stałych układów rekordów.
Dryf schematu występuje, gdy usługi rozproszone i komponenty komputera mainframe nie są ze sobą zgodne. Pole dodane lub ponownie zinterpretowane w usłudze może nie zostać rozpoznane przez program COBOL, co prowadzi do błędów parsowania lub nieprawidłowego przetwarzania. Podczas migracji przyrostowej problemy te mogą pojawiać się sporadycznie, ponieważ usługi ewoluują niezależnie.
Wyzwanie pogłębia brak wyraźnego egzekwowania kontraktów na różnych platformach. Usługi rozproszone mogą opierać się na elastycznych formatach serializacji, podczas gdy programy mainframe wymagają ścisłych układów. Bez rygorystycznej koordynacji zmiany schematów rozprzestrzeniają się w sposób nieprzewidywalny.
Problem ten jest ściśle powiązany z wyzwaniami omawianymi w kontekście radzenia sobie z niedopasowaniami kodowania danych , gdzie subtelne różnice w reprezentacji danych zakłócają integrację. W migracji przyrostowej dryf schematu musi być aktywnie zarządzany, aby zapobiec błędom integracji.
Wzmocnienie opóźnienia i propagacja awarii
Usługi rozproszone wprowadzają opóźnienia sieciowe i tryby częściowej awarii, które są obce tradycyjnemu przetwarzaniu na komputerach mainframe. Podczas gdy komponenty komputerów mainframe są projektowane z myślą o wysokiej przepustowości i niskich opóźnieniach w kontrolowanym środowisku, integracje rozproszone wprowadzają zmienność.
Wzmocnienie opóźnień występuje, gdy opóźnienia w usługach rozproszonych kaskadowo przechodzą przez łańcuchy wykonawcze. Powolna reakcja usługi może zablokować postęp przetwarzania wsadowego lub obniżyć wydajność online. Migracja przyrostowa stopniowo naraża systemy na te efekty, utrudniając ich przewidywanie.
Propagacja awarii staje się również bardziej złożona. Przejściowa awaria usługi może skutkować opóźnieniami wsadowymi, błędami transakcji online lub niespójnymi stanami danych. Procedury odzyskiwania muszą uwzględniać te interakcje, a mimo to często są projektowane z uwzględnieniem założeń jednej platformy.
Migracja przyrostowa jest skuteczna, gdy usługi rozproszone są zintegrowane z pełną świadomością ich wpływu na starszą semantykę wykonania. Bez tej świadomości każda nowa usługa zwiększa złożoność i ryzyko związane z migracją.
Integracja usług rozproszonych nie jest zatem jedynie szczegółem technicznym, ale kluczowym czynnikiem decydującym o powodzeniu migracji przyrostowej. Kontrolowanie jej wpływu jest kluczowe dla utrzymania stabilności podczas modernizacji na różnych platformach.
Przyrostowa migracja bez całkowitego zamrożenia systemu lub równoległych uruchomień
Jednym z najsilniejszych czynników napędzających stopniową migrację komputerów mainframe jest potrzeba modernizacji bez przerywania operacji produkcyjnych. Duże przedsiębiorstwa rzadko mają możliwość zamrożenia systemów na dłuższy czas lub uruchomienia w pełni równoległych środowisk w nieskończoność. Cykle biznesowe, obowiązki regulacyjne i zapotrzebowanie klientów wymagają ciągłej dostępności, nawet w miarę ewolucji systemów bazowych.
Jednak unikanie zawieszeń systemu i długich przebiegów równoległych niesie ze sobą szereg wyzwań technicznych. Migracja przyrostowa musi równoważyć postęp z ciągłością operacyjną, zapewniając możliwość wprowadzania, walidacji i, w razie potrzeby, cofania zmian bez destabilizacji produkcji. Osiągnięcie tej równowagi wymaga starannej kontroli zakresu wykonania, jasnych granic wycofania oraz zrozumienia, jak współistnienie wpływa na zachowanie systemu w czasie.
Określanie bezpiecznych przyrostów migracji, które ograniczają narażenie operacyjne
Migracja przyrostowa kończy się sukcesem, gdy każdy jej etap stanowi ograniczoną i kontrolowaną zmianę. Definiowanie takich przyrostów jest znacznie bardziej złożone niż wybór poszczególnych programów lub usług do migracji. Bezpieczne przyrosty muszą uwzględniać zależności wykonania, własność danych i semantykę awarii wykraczającą poza granice kodu.
W praktyce niebezpieczne przyrosty często pojawiają się, gdy zakres migracji jest definiowany wyłącznie ze względów technicznych. Wyodrębnienie programu COBOL, który wydaje się być samodzielny, może ignorować jego rolę w szerszym łańcuchu wykonawczym. Migracja takiego programu zwiększa ryzyko operacyjne, ponieważ systemy niższego rzędu mogą zachowywać się inaczej w warunkach obciążenia lub awarii.
Bezpieczne przyrosty definiuje się poprzez ograniczenie operacyjnego promienia rażenia zmian. Oznacza to zapewnienie, że migrowane komponenty mogą ulec awarii niezależnie, bez konieczności przeprowadzania szeroko zakrojonych działań naprawczych. Aby to osiągnąć, konieczne jest zrozumienie, które komponenty współdzielą ścieżki wykonywania, które zmiany wprowadzają nowe zależności oraz gdzie występują granice wycofania.
Bez tej dyscypliny, stopniowa migracja staje się ryzykownym eksperymentem, a nie kontrolowaną transformacją. Zespoły mogą być zmuszone do wstrzymania migracji lub wprowadzenia doraźnego paralelizmu w celu ustabilizowania systemów, niwecząc zamierzone korzyści płynące z postępów stopniowych.
Unikanie długoterminowych modeli równoległego wykonywania zadań
Wykonywanie równoległe jest często stosowane jako strategia minimalizacji ryzyka podczas migracji. Równoległe uruchamianie starszych i zmigrowanych komponentów pozwala zespołom porównywać działania i weryfikować ich poprawność. Choć jest to skuteczne w krótkiej perspektywie, w dłuższej perspektywie równoległość wprowadza złożoność operacyjną, która może przeważyć nad korzyściami.
Utrzymywanie środowisk równoległych wymaga duplikowania przepływów danych, synchronizowania stanu i uzgadniania różnic między systemami. Z czasem czynności te pochłaniają znaczne zasoby operacyjne i wprowadzają nowe tryby awarii. Systemy równoległe mogą utracić spójność, co sprawia, że porównania stają się mało wiarygodne, a odzyskiwanie danych w przypadku incydentów staje się bardziej złożone.
Migracja przyrostowa ma na celu zminimalizowanie zależności od długoterminowego paralelizmu poprzez umożliwienie pewnych przełączeń. Ta pewność wynika ze zrozumienia zachowania i wpływu wykonania przed wprowadzeniem zmian. Gdy zespoły wiedzą, jak systemy będą zachowywać się po migracji, równoległe przebiegi mogą zostać ograniczone do ukierunkowanej walidacji, a nie do długotrwałego współistnienia.
Wyzwaniem jest określenie, kiedy paralelizm jest rzeczywiście konieczny, a kiedy można go bezpiecznie wyeliminować. Bez jasnych kryteriów organizacje domyślnie decydują się na rozszerzoną pracę równoległą, co spowalnia migrację i zwiększa koszty.
Projektowanie granic wycofywania, które zachowują stabilność
Możliwość wycofania zmian jest niezbędna do przeprowadzenia migracji przyrostowej bez zawieszania się. Po wprowadzeniu zmian do środowiska produkcyjnego, zespoły muszą mieć możliwość szybkiego wycofania zmian w przypadku wystąpienia nieoczekiwanego zachowania. Zaprojektowanie efektywnych granic wycofania zmian wymaga czegoś więcej niż kontroli wersji. Wymaga ona uwzględnienia w architekturze stanu, danych i przepływu wykonania.
W środowiskach mainframe, wycofywanie często opiera się na dobrze znanych mechanizmach ponownego uruchamiania i odzyskiwania zadań. Wraz z migracją komponentów, mechanizmy te mogą przestać działać bezpośrednio. Systemy rozproszone mogą obsługiwać wycofywanie w inny sposób, polegając na działaniach kompensacyjnych zamiast deterministycznych restartów.
Migracja przyrostowa musi pogodzić te podejścia. Granice wycofania powinny być zdefiniowane w taki sposób, aby przywrócenie zmigrowanego komponentu nie pozostawiło systemu w stanie niespójnym. Często wymaga to izolowania zmian danych lub zapewnienia idempotentności działania w różnych granicach.
Brak solidnych granic wycofania prowadzi do ostrożnych praktyk wdrażania, które spowalniają migrację. Zespoły wahają się przed wprowadzaniem zmian bez przeprowadzenia gruntownego testowania, co wydłuża czas potrzebny do osiągnięcia oczekiwanych rezultatów. Przejrzyste strategie wycofania umożliwiają częstsze i pewniejsze kroki migracyjne.
Ciągła praca w warunkach zmian wywołanych migracją
Utrzymanie ciągłości działania podczas migracji wymaga, aby systemy tolerowały ciągłe zmiany. Wzorce obciążenia, czas wykonywania i wykorzystanie zasobów mogą ulegać zmianom w miarę przenoszenia komponentów między platformami. Zmiany te mogą ujawniać ukryte problemy z wydajnością lub rywalizacją.
Migracja przyrostowa musi zatem uwzględniać dynamikę operacyjną, a nie tylko poprawność funkcjonalną. Zmiany, które są bezpieczne przy obciążeniu nominalnym, mogą powodować degradację w warunkach szczytowych. Bez starannego monitorowania i analizy, takie problemy mogą ujawnić się dopiero po zakończeniu etapów migracji, co utrudni ich rozwiązanie.
To wyzwanie jest ściśle powiązane z problemami omawianymi w kontekście refaktoryzacji mainframe'ów w trybie ciągłej integracji , gdzie częste zmiany wymagają zdyscyplinowanych praktyk integracyjnych. W kontekście migracji podobna dyscyplina jest wymagana do zapewnienia stabilności.
Ciągłe działanie w warunkach zmian wymaga, aby etapy migracji były obserwowalne, odwracalne i izolowane. Gdy te warunki są spełnione, migracja przyrostowa może przebiegać bez zamrożeń i wydłużonego paralelizmu. W przeciwnym razie organizacje są zmuszone do stosowania konserwatywnych strategii, które niweczą korzyści z zakresu zwinności wynikające z transformacji przyrostowej.
Migracja przyrostowa bez zawieszania się systemu jest możliwa do osiągnięcia, ale tylko wtedy, gdy realia operacyjne są traktowane jako ograniczenia najwyższej klasy. Definiując bezpieczne przyrosty, ograniczając paralelizm, projektując granice wycofania i uwzględniając ciągłość działania, organizacje mogą przeprowadzać stabilną modernizację bez utraty stabilności.
Smart TS XL i deterministyczna analiza dla przyrostowej migracji komputerów mainframe
Przyrostowa migracja komputerów mainframe w językach COBOL, JCL i usługach rozproszonych kończy się sukcesem lub porażką w zależności od jakości wiedzy o systemie dostępnej przed wprowadzeniem zmian. W środowiskach, w których zachowanie, zależności i przepływy danych są jedynie częściowo zrozumiane, decyzje dotyczące migracji w dużej mierze opierają się na założeniach. Założenia te kumulują ryzyko w kolejnych fazach, zmuszając zespoły do spowolnienia postępu lub wprowadzenia kompensujących mechanizmów kontroli, które podważają model przyrostowy.
Rozwiązanie Smart TS XL rozwiązuje ten problem, zapewniając deterministyczny wgląd w system, oparty na analizie statycznej i analizie wpływu, a nie na obserwacji w czasie wykonywania. Jego rolą w migracji przyrostowej nie jest automatyzacja transformacji, lecz redukcja niepewności poprzez wyraźne określenie ścieżek wykonania, zależności i interakcji międzyplatformowych. Ta przejrzystość umożliwia zespołom migracyjnym planowanie fazowej ekstrakcji i integracji z pewnością, nawet w przypadku głęboko powiązanych systemów starszej generacji.
Wstępnie obliczona inteligencja wykonania w językach COBOL i JCL
Jednym z głównych wkładów Smart TS XL w migrację przyrostową jest możliwość prezentowania inteligencji wykonawczej w programach COBOL i powiązanych z nimi przepływach pracy JCL. Zamiast traktować programy i strumienie zadań jako oddzielne artefakty, Smart TS XL analizuje ich interakcje, aby generować rzeczywiste zachowanie wykonania w środowisku produkcyjnym.
Ta wstępnie obliczona inteligencja ujawnia, które programy są uruchamiane w jakich warunkach, jak rozgałęziają się kroki zadań oraz gdzie logika restartu i odzyskiwania wpływa na przepływ sterowania. Dla zespołów ds. migracji informacje te są kluczowe przy definiowaniu granic ekstrakcji. Gwarantują one, że programy nie będą migrowane w oderwaniu od kontekstu wykonania, który kształtuje ich zachowanie.
Dzięki wcześniejszemu zrozumieniu struktury wykonania, zespoły mogą identyfikować bezpieczne kandydatury do migracji i unikać komponentów, których zachowanie jest ściśle powiązane ze złożoną logiką zadania. Zmniejsza to prawdopodobieństwo dryfu behawioralnego i minimalizuje nakład pracy na stabilizację po zakończeniu etapów migracji.
Inteligencja wykonania wspiera również dokładniejsze strategie testowania. Zamiast polegać wyłącznie na testach funkcjonalnych, zespoły mogą zweryfikować, czy migrowane komponenty zachowują ścieżki wykonania zaobserwowane w starszym środowisku. Taka walidacja zmniejsza ryzyko wystąpienia subtelnych odchyleń, które ujawniają się tylko w rzadkich przypadkach.
Przejrzystość zależności między komputerem mainframe a usługami rozproszonymi
Migracja przyrostowa wprowadza hybrydowe środowiska wykonawcze, w których komputery mainframe i komponenty rozproszone współistnieją przez dłuższy czas. W takich środowiskach transparentność zależności staje się niezbędna. Bez jasnego wglądu w interakcje komponentów między platformami, decyzje dotyczące migracji są ograniczone przez niepewność.
Smart TS XL zapewnia wgląd w zależności obejmujące języki, środowiska wykonawcze i modele wykonania. Ujawnia relacje, które nie są widoczne wyłącznie w definicjach interfejsów, takie jak współużytkowanie danych, pośrednie ścieżki wywołań i zależności warunkowe. Ta transparentność umożliwia zespołom wnioskowanie o wpływie migracji komponentu poza jego bezpośredni zakres.
Na przykład migracja programu COBOL może wydawać się mało ryzykowna, dopóki analiza zależności nie wykaże, że odbiorcy w usługach rozproszonych bazują na określonych stanach danych lub synchronizacji. Dzięki tej wiedzy zespoły mogą dostosować kolejność migracji lub wprowadzić zabezpieczenia w celu zachowania stabilności.
Przejrzystość zależności zmniejsza również potrzebę długotrwałych przebiegów równoległych. Rozumiejąc strukturę zależności, zespoły mogą przewidywać, jak zmiany będą się rozprzestrzeniać i odpowiednio planować przejścia. Ta funkcja umożliwia stopniową migrację bez nadmiernego obciążenia operacyjnego.
To podejście jest zgodne z zasadami omawianymi w analizie statycznej i analizie wpływu , gdzie zrozumienie relacji umożliwia bezpieczniejszą zmianę. W kontekście migracji ta sama zasada umożliwia bezpieczniejszą transformację etapową.
Wspieranie ekstrakcji fazowej bez domysłów behawioralnych
Jednym z najpoważniejszych wyzwań w migracji przyrostowej jest domysły behawioralne. Zespoły często działają w oparciu o niepełną wiedzę, polegając na monitorowaniu po migracji w celu wykrycia problemów. To reaktywne podejście zwiększa ryzyko i spowalnia postęp.
Smart TS XL redukuje domysły, umożliwiając zespołom modelowanie scenariuszy migracji przed ich wykonaniem. Rozumiejąc ścieżki i zależności wykonania, zespoły mogą przewidywać zmiany w zachowaniu po przeniesieniu komponentów. Taka prognoza pozwala na proaktywne ograniczanie ryzyka zamiast reaktywnej korekty.
Ekstrakcja etapowa staje się kontrolowanym procesem, a nie eksperymentem. Zespoły mogą identyfikować, które zachowania należy zachować, które można bezpiecznie zmienić, a które wymagają przeprojektowania. Ta przejrzystość wspiera stały postęp bez powtarzających się cykli wycofywania zmian.
Wiedza behawioralna usprawnia również komunikację między zespołami. Gdy decyzje dotyczące migracji opierają się na wspólnym zrozumieniu, koordynacja między zespołami mainframe i rozproszonymi staje się bardziej efektywna. Takie dopasowanie zmniejsza tarcia i przyspiesza harmonogram migracji.
Umożliwianie migracji przyrostowej jako dyscyplina inżynierska
Ostatecznie, Smart TS XL wspiera transformację przyrostowej migracji komputerów mainframe z doraźnego działania w dziedzinę inżynierską. Zapewniając spójny, deterministyczny wgląd w zachowanie systemu, umożliwia zespołom stosowanie powtarzalnych praktyk w różnych fazach migracji.
Ta dyscyplina przekłada się na bardziej przejrzyste plany migracji, bardziej przewidywalne rezultaty i mniejsze wahania w wysiłkach stabilizacyjnych. Etapy migracji stają się mniejsze, bezpieczniejsze i łatwiejsze do oceny. Z czasem organizacje zyskują pewność, że mogą modernizować się bez narażania stabilności produkcji.
Smart TS XL nie zastępuje oceny architektury ani wiedzy specjalistycznej. Zamiast tego wzmacnia ich skuteczność, opierając decyzje na dowodach, a nie na intuicji. W złożonych środowiskach hybrydowych takie ugruntowanie jest niezbędne do utrzymania dynamiki w długotrwałych programach migracji.
Dzięki zmniejszeniu niepewności i ujawnieniu struktury systemu, Smart TS XL umożliwia stopniową migrację komputerów mainframe, aby przebiegała ona pewnie, pod kontrolą i z zachowaniem ciągłości.
Od eksperymentów przyrostowych do przewidywalnej transformacji komputerów mainframe
Wiele inicjatyw przyrostowej migracji komputerów mainframe rozpoczyna się od kontrolowanych eksperymentów. Migrowany jest niewielki podzbiór programów, wprowadzana jest ograniczona integracja lub modernizowane jest określone obciążenie w celu weryfikacji wykonalności. Chociaż te eksperymenty często kończą się sukcesem technicznym, często nie udaje się ich skalować. To, co sprawdza się w przypadku pojedynczego komponentu, nie przekłada się automatycznie na powtarzalne podejście do transformacji w całym systemie.
Przewidywalna transformacja komputerów mainframe pojawia się, gdy migracja przyrostowa ewoluuje od etapu eksperymentalnego do zdyscyplinowanej praktyki inżynierskiej. Ta zmiana wymaga spójności w podejmowaniu decyzji dotyczących migracji, ocenie wyników i stosowaniu wniosków na kolejnych etapach. Bez tej dyscypliny organizacje pozostają w pułapce trybu pilotażowego, niezdolne do przyspieszenia postępów bez zwiększania ryzyka.
Standaryzacja decyzji migracyjnych w systemach heterogenicznych
Jednym z kluczowych wyzwań w skalowaniu migracji przyrostowej jest brak ustandaryzowanych kryteriów decyzyjnych. Każdy etap migracji jest często oceniany niezależnie, w oparciu o lokalną wiedzę lub bezpośrednie ograniczenia. Chociaż ta elastyczność sprzyja wczesnym eksperymentom, wprowadza niespójność wraz z rozszerzaniem się zakresu.
W środowiskach heterogenicznych programy COBOL, przepływy pracy JCL i usługi rozproszone znacznie różnią się pod względem złożoności i krytyczności. Bez wspólnych ram oceny gotowości do migracji zespoły podejmują decyzje, które trudno porównać lub powtórzyć. Jeden zespół może migrować agresywnie, podczas gdy inny przyjmuje podejście konserwatywne, co prowadzi do nierównomiernego postępu.
Standaryzacja nie oznacza sztywnych reguł. Zamiast tego polega na zdefiniowaniu wspólnych wymiarów oceny, takich jak gęstość zależności, złożoność ścieżki wykonania i wpływ awarii. Spójne stosowanie tych wymiarów umożliwia porównywanie decyzji migracyjnych między systemami.
Taka spójność zmniejsza tarcia wewnętrzne i poprawia dokładność planowania. Interesariusze zyskują lepszy wgląd w ryzyko i nakład pracy związany z migracją, co pozwala na bardziej realistyczne harmonogramy. Z czasem, standaryzowane podejmowanie decyzji przekształca stopniową migrację z serii odizolowanych zakładów w skoordynowany program transformacji.
Przekształcanie wysiłków stabilizacyjnych w praktyczną informację zwrotną
Wczesne fazy migracji często wymagają znacznych nakładów pracy na rzecz stabilizacji. Wykrywane są problemy, stosowane są obejścia, a systemy są dostrajane w celu przywrócenia akceptowalnego zachowania. W wielu organizacjach ten wysiłek jest traktowany jako tymczasowy koszt, a nie źródło wiedzy.
Gdy wyniki stabilizacji nie są systematycznie rejestrowane, zespoły powtarzają te same błędy w kolejnych fazach. Podobne problemy pojawiają się ponownie, pochłaniając czas i podważając zaufanie. Migracja stopniowa zatrzymuje się, ponieważ każdy kolejny krok wydaje się równie ryzykowny, jak pierwszy.
Przewidywalna transformacja wymaga przekształcenia wysiłków stabilizacyjnych w praktyczną informację zwrotną. Zespoły muszą analizować przyczyny wystąpienia problemów, które założenia okazały się błędne i jak przyszłe migracje mogą uniknąć podobnych problemów. Ta pętla sprzężenia zwrotnego przekształca trudności operacyjne w wiedzę inżynierską.
Z czasem proces ten zmniejsza nakład pracy związany ze stabilizacją na każdym etapie migracji. Dzięki proaktywnemu identyfikowaniu i rozwiązywaniu wzorców, migracja staje się płynniejsza i bardziej przewidywalna. Organizacje, które inwestują w wyciąganie wniosków z wczesnych faz, przyspieszają późniejsze etapy bez zwiększania ryzyka.
Zrzeszanie zespołów wokół wspólnego zrozumienia realizacji zadań
Migracja przyrostowa przekracza granice organizacyjne. Specjaliści od komputerów mainframe, inżynierowie systemów rozproszonych, zespoły operacyjne i interesariusze biznesowi – wszyscy przyczyniają się do sukcesu. Brak współpracy między tymi grupami jest częstym źródłem tarć i opóźnień.
Wspólne rozumienie realizacji zadań stanowi podstawę do harmonizacji. Kiedy zespoły zgadzają się co do tego, jak systemy zachowują się obecnie i jak mają się zachowywać po migracji, koordynacja ulega poprawie. Decyzje opierają się na wspólnych modelach, a nie na sprzecznych reprezentacjach mentalnych.
Takie dopasowanie skraca opóźnienia w przekazywaniu zadań i minimalizuje konieczność przeróbek. Zespoły mogą współpracować efektywniej, ponieważ działają w oparciu o tę samą wiedzę na temat zależności i przepływu wykonania. W rezultacie etapy migracji przebiegają sprawniej.
Spójność usprawnia również komunikację z interesariuszami nietechnicznymi. Wyjaśnienie wyników migracji w kontekście ciągłości realizacji i redukcji ryzyka sprawia, że oczekiwania stają się jaśniejsze. Ta jasność wspiera stałe inwestycje i zaangażowanie w długoterminowe programy transformacyjne.
Budowanie pewności siebie poprzez powtarzalność i przewidywalność
Pewność siebie jest kluczowym czynnikiem umożliwiającym migrację na dużą skalę. Wczesne sukcesy mogą budzić entuzjazm, ale pewność siebie utrzymuje się tylko wtedy, gdy wyniki pozostają przewidywalne w dłuższej perspektywie. Organizacje tracą impet, gdy każdy etap migracji wydaje się niepewny, niezależnie od wcześniejszych doświadczeń.
Przewidywalność buduje zaufanie, ograniczając niespodzianki. Kiedy zespoły potrafią przewidywać wyzwania i konsekwentnie sobie z nimi radzić, migracja staje się mniej stresująca i bardziej rutynowa. Ta zmiana zmienia zachowania organizacyjne. Zespoły chętniej podejmują się złożonych zadań i rzadziej odkładają trudne decyzje na później.
Powtarzanie wzmacnia tę pewność. W miarę jak etapy migracji podążają znanymi schematami, zespoły udoskonalają swoje podejście i zwiększają wydajność. Transformacja nabiera tempa, przechodząc od eksperymentów do realizacji.
Ta ewolucja odzwierciedla szersze zasady omawiane w strategiach stopniowej modernizacji , w których przewidywalność umożliwia skalowanie. Stopniowa migracja komputerów mainframe osiąga swój pełny potencjał, gdy staje się powtarzalną praktyką inżynierską, a nie serią odizolowanych eksperymentów.
Standaryzując decyzje, ucząc się na stabilizacjach, koordynując zespoły i budując zaufanie poprzez powtarzalność, organizacje przekształcają stopniową migrację w przewidywalną ścieżkę rozwoju. Ta transformacja umożliwia trwałą modernizację bez utraty stabilności, której wymagają systemy o znaczeniu krytycznym.
Fragmentacja przepływu danych podczas przyrostowej migracji COBOL i JCL
Fragmentacja przepływu danych jest jednym z najmniej widocznych, a jednocześnie najbardziej uciążliwych wyzwań w przyrostowej migracji komputerów mainframe. Ponieważ programy COBOL i przepływy pracy JCL są migrowane etapami, własność danych i odpowiedzialność za przetwarzanie są często rozdzielone między platformy. Chociaż ta fragmentacja może wydawać się łatwa do opanowania na poziomie strukturalnym, wprowadza ona złożoność behawioralną, która osłabia stabilność, jeśli nie zostanie rozwiązana.
W starszych środowiskach przepływy danych ewoluowały wraz z logiką wykonania. Cykle wsadowe, cykle życia zbiorów danych i sekwencjonowanie programów łącznie zapewniały generowanie, transformację i przetwarzanie danych zgodnie z przewidywalnymi wzorcami. Migracja przyrostowa zmienia te wzorce, wprowadzając nowe konteksty wykonania i modele częściowej własności. Bez wyraźnej kontroli, pofragmentowane przepływy danych stają się źródłem niespójności, która spowalnia migrację i zwiększa ryzyko operacyjne.
Częściowa własność danych na różnych platformach
Migracja przyrostowa często skutkuje częściową własnością danych, gdzie niektóre rekordy są generowane lub aktualizowane przez migrowane komponenty, a inne pozostają pod kontrolą starszych wersji. Ten podział własności komplikuje założenia, które wcześniej były niejawne. Programy COBOL i przepływy pracy JCL często zakładają wyłączny dostęp do zestawów danych w określonych oknach czasowych, co nie jest już aktualne po wprowadzeniu usług rozproszonych.
Częściowa własność tworzy niejasność co do tego, który system jest autorytatywny dla określonych elementów danych w danym momencie. Podczas normalnego działania ta niejasność może pozostać ukryta. W przypadku awarii lub podczas cykli uzgadniania, niespójności ujawniają się, wymagając ręcznej interwencji w celu ich rozwiązania.
To wyzwanie jest spotęgowane, gdy granice własności nie są zgodne z semantyką biznesową. Migracja komponentu technicznego bez migracji powiązanej z nim domeny danych prowadzi do sytuacji, w których logika i odpowiedzialność za dane są rozbieżne. Zespoły muszą wówczas koordynować działania między platformami, aby zapewnić spójność, co zwiększa obciążenie operacyjne.
Skuteczna migracja przyrostowa wymaga wyraźnego określenia własności danych i dostosowania jej do faz migracji. Bez tego dostosowania fragmentacja przepływu danych wprowadza subtelne błędy, które podważają zaufanie do wyników migracji.
Fragmentacja czasowa w potokach danych sterowanych wsadowo
Przetwarzanie danych wsadowych w dużym stopniu opiera się na koordynacji czasowej. Dane powinny być kompletne, spójne i dostępne w określonych momentach. Migracja przyrostowa zakłóca tę koordynację, zmieniając czas wykonywania i wprowadzając nowe etapy przetwarzania.
Podczas migracji części potoku wsadowego czas wykonywania może ulec zmianie. Rozproszone struktury przetwarzania mogą wykonywać zadania szybciej lub wolniej niż zadania na komputerach mainframe, co powoduje przesunięcie okien dostępności danych. Procesy downstream, które opierają się na określonych założeniach czasowych, mogą napotkać niekompletne lub nieaktualne dane.
Fragmentacja czasowa jest szczególnie trudna do zdiagnozowania, ponieważ często pojawia się okresowo. W normalnych warunkach różnice czasowe mogą być nieznaczne. W scenariuszach obciążenia szczytowego lub odzyskiwania po awarii, opóźnienia kumulują się i ujawniają ukryte zależności.
Rozwiązanie problemu fragmentacji czasowej wymaga zrozumienia nie tylko zależności danych, ale także zależności czasowych. Zespoły ds. migracji muszą zidentyfikować miejsca występowania założeń czasowych i upewnić się, że są one zachowane lub bezpośrednio dostosowane. Bez tego, migracja przyrostowa wprowadza sytuacje wyścigu, które zagrażają integralności danych.
Ryzyko duplikacji i rozbieżności danych
Aby zminimalizować ryzyko, organizacje czasami duplikują dane podczas migracji przyrostowej. Starsze systemy nadal generują zestawy danych, podczas gdy migrowane komponenty utrzymują kopie równoległe. Chociaż duplikacja może zapewnić krótkoterminowe bezpieczeństwo, niesie ze sobą ryzyko rozbieżności w dłuższej perspektywie.
Zachowanie spójności między zduplikowanymi zbiorami danych wymaga mechanizmów synchronizacji, które często są złożone i niestabilne. Drobne opóźnienia lub awarie mogą powodować rozbieżności między zbiorami danych, co prowadzi do problemów z uzgadnianiem i utraty zaufania do dokładności danych.
Ryzyko rozbieżności rośnie wraz z narastaniem faz migracji. Każdy nowy komponent dodany do środowiska hybrydowego zwiększa liczbę punktów synchronizacji. Z czasem zarządzanie tymi punktami staje się istotnym obciążeniem operacyjnym.
Ten problem jest ściśle powiązany z wyzwaniami opisanymi w planowaniu przyrostowej migracji danych , gdzie częściowe przenoszenie danych musi być starannie kontrolowane. Migracja przyrostowa przynosi korzyści, gdy duplikacja danych jest minimalizowana, a zmiany własności są jasno zdefiniowane.
Przywracanie widoczności przepływu danych od początku do końca
Fragmentaryczne przepływy danych utrudniają wgląd w sposób, w jaki dane przemieszczają się w systemie. W starszych środowiskach doświadczone zespoły mogły wnioskować o pochodzeniu danych na podstawie harmonogramów zadań i sekwencji programów. Migracja przyrostowa zaciemnia to pochodzenie, rozkładając przetwarzanie na platformy.
Bez pełnej widoczności diagnozowanie problemów z danymi staje się czasochłonne i podatne na błędy. Zespoły muszą ręcznie śledzić dane w różnych systemach, co wydłuża MTTR podczas incydentów i spowalnia postęp migracji.
Przywrócenie widoczności wymaga mapowania przepływów danych zarówno w starszych, jak i zmigrowanych komponentach. To mapowanie pozwala zespołom zrozumieć, skąd pochodzą dane, jak są przekształcane i gdzie są wykorzystywane. Dzięki temu zrozumieniu niespójności można skuteczniej identyfikować i rozwiązywać.
Widoczność przepływu danych wspomaga również lepsze planowanie migracji. Gdy zespoły rozumieją, jak przepływy danych ewoluują na różnych etapach, mogą zaprojektować kroki migracji, które minimalizują fragmentację. Z czasem takie podejście zmniejsza złożoność i stabilizuje operacje.
Fragmentacja przepływu danych nie jest nieuniknioną konsekwencją migracji przyrostowej, ale jest częsta. Proaktywne podejście do tego problemu jest niezbędne do zachowania spójności, zaufania i dynamiki w miarę ewolucji obciążeń COBOL i JCL na różnych platformach.
Zachowywanie semantyki awarii w fazach migracji przyrostowej
Semantyka awarii definiuje zachowanie systemów w przypadku awarii. W starszych środowiskach mainframe semantyka ta jest głęboko osadzona w przepływie wykonywania, kontroli zadań i procedurach operacyjnych. Punkty ponownego uruchomienia, kody błędów, rozgałęzienia warunkowe i logika odzyskiwania wspólnie decydują o sposobie wykrywania, ograniczania i rozwiązywania awarii. Migracja przyrostowa stwarza ryzyko, gdy ta semantyka zostanie nieumyślnie zmieniona.
Zachowanie semantyki awarii w różnych fazach migracji jest kluczowe dla stabilności operacyjnej. Nawet jeśli zachowanie funkcjonalne wydaje się niezmienione, różnice w sposobie propagacji lub obsługi awarii mogą prowadzić do nieprzewidywalnych skutków. Migracja przyrostowa musi zatem traktować zachowanie awarii priorytetowo, zapewniając ciągłość nie tylko na ścieżkach sukcesu, ale także w scenariuszach błędów.
Logika ponownego uruchamiania i odzyskiwania osadzona w zewnętrznym kodzie aplikacji
W środowiskach mainframe logika restartu i odzyskiwania jest często rozproszona w obrębie JCL, konfiguracji harmonogramu i konwencji operacyjnych, a nie scentralizowana w kodzie aplikacji. Programy COBOL mogą korzystać z zewnętrznych mechanizmów zarządzania częściowym wykonywaniem, punktami kontrolnymi i ponownymi uruchomieniami. Mechanizmy te definiują sposób odzyskiwania systemów po awariach bez ręcznej interwencji.
Migracja przyrostowa często koncentruje się na logice aplikacji, pomijając zewnętrzne konstrukcje odzyskiwania. Po migracji komponentów, w środowisku docelowym może nie być dostępne analogiczne zachowanie restartu. Systemy rozproszone często opierają się na różnych paradygmatach odzyskiwania, takich jak bezstanowe ponowne próby lub transakcje kompensacyjne.
Ta rozbieżność stwarza ryzyko. Awaria, którą wcześniej można było naprawić poprzez proste ponowne uruchomienie, może teraz wymagać złożonej interwencji ręcznej. Zespoły operacyjne mogą odkryć, że ustalone procedury nie mają już zastosowania, co wydłuża przestoje podczas incydentów.
Zachowanie semantyki restartu wymaga zidentyfikowania aktualnej lokalizacji logiki odzyskiwania i zapewnienia jej jawnej replikacji lub adaptacji. To zadanie nie jest trywialne, ponieważ mechanizm odzyskiwania rzadko jest kompleksowo dokumentowany. Wynika on z interakcji kodu, projektu zadania i praktyki operacyjnej.
Różnice w propagacji błędów między platformami
Zachowanie propagacji błędów różni się znacząco między środowiskami mainframe i rozproszonymi. W tradycyjnych systemach mainframe błędy często są zawarte w ściśle zdefiniowanych kontekstach wykonania. Kody powrotu, kody warunkowe i obsługa awaryjnego zakończenia dostarczają ustrukturyzowanych sygnałów, które kierują zachowaniem w dół strumienia.
Systemy rozproszone propagują błędy w różny sposób. Wyjątki mogą przenikać przez warstwy usług, ponowne próby mogą ukrywać pierwotne przyczyny, a częściowe awarie mogą utrzymywać się bez wyraźnych sygnałów. Migracja przyrostowa wprowadza hybrydowe ścieżki wykonywania, w których te różne semantyki współistnieją.
Bez starannego zarządzania sygnały błędów mogą zostać utracone lub błędnie zinterpretowane podczas przenoszenia komponentów. Awaria, która kiedyś zatrzymała zadanie wsadowe, może teraz wywołać ponowne próby maskujące problem. Z drugiej strony, przejściowe błędy rozproszone mogą ujawnić się jako awarie krytyczne w starszych komponentach.
Zrozumienie i dostosowanie propagacji błędów jest kluczowe dla zachowania oczekiwanego zachowania. Zespoły muszą zmapować obecny przepływ błędów przez ścieżki wykonania i zapewnić równoważną sygnalizację po migracji. To wyzwanie jest ściśle powiązane z zagadnieniami omawianymi w rozdziale „ Wpływ obsługi wyjątków na wydajność” , gdzie wybory dotyczące obsługi błędów wpływają na zachowanie systemu.
Unikanie zmian trybu cichej awarii
Jednym z najniebezpieczniejszych skutków migracji przyrostowej jest wprowadzenie cichych zmian trybu awarii. Mają one miejsce, gdy systemy pozornie działają poprawnie, ale radzą sobie z awariami inaczej niż wcześniej. Takie zmiany mogą nie wywołać natychmiastowych alarmów, ale z czasem obniżyć niezawodność.
Na przykład, migrowany komponent może wychwycić i zarejestrować błędy, które zostały wcześniej rozpropagowane, uniemożliwiając aktywację zabezpieczeń niższego szczebla. Alternatywnie, awaria może zostać ponowiona automatycznie, opóźniając wykrycie do momentu wyczerpania zasobów.
Ciche zmiany są trudne do wykrycia podczas testów, ponieważ często ujawniają się tylko w określonych warunkach. Zespoły operacyjne mogą nie zauważyć ich aż do wystąpienia incydentów w produkcji, w którym to momencie diagnoza jest utrudniona przez zmianę zachowania.
Zapobieganie zmianom trybu cichej awarii wymaga jednoznacznego porównania zachowania awarii przed i po migracji. Zespoły muszą zweryfikować nie tylko to, czy awarie występują w oczekiwanym czasie, ale także to, czy są obsługiwane w równoważny sposób. Ta walidacja wymaga dogłębnego zrozumienia semantyki awarii i ich odpowiedników w środowisku docelowym.
Utrzymywanie ważności podręcznika operacyjnego podczas migracji
Operacyjne podręczniki runbook kodyfikują sposób, w jaki zespoły reagują na awarie. Są one zbudowane wokół oczekiwanej semantyki awarii, kroków odzyskiwania i zachowania systemu. Migracja przyrostowa zagraża ważności podręcznika runbook, gdy zachowanie awarii ulega zmianie bez odpowiednich aktualizacji.
Wraz z migracją komponentów, podręczniki runbook mogą stać się częściowo przestarzałe. Procedury, które kiedyś szybko rozwiązywały problemy, mogą przestać obowiązywać, co prowadzi do zamieszania i opóźnień w reakcji. W sytuacjach wysokiego napięcia, poleganie na przestarzałych podręcznikach runbook zwiększa ryzyko.
Utrzymanie ważności runbooka wymaga dostosowania dokumentacji operacyjnej do faz migracji. Zespoły muszą aktualizować procedury w miarę ewolucji semantyki awarii, aby zapewnić personelowi operacyjnemu przygotowanie na nowe zachowania. Ten wysiłek jest często pomijany w planowaniu migracji technicznej.
Skuteczna migracja przyrostowa traktuje gotowość operacyjną jako integralną część sukcesu. Zachowanie semantyki awarii wspiera ciągłość działania, umożliwiając zespołom skuteczne reagowanie nawet w przypadku zmian systemowych.
Zachowanie semantyki awarii w kolejnych fazach migracji przyrostowej gwarantuje, że modernizacja nie wpłynie negatywnie na niezawodność. Dzięki zajęciu się logiką ponownego uruchamiania, propagacją błędów, trybami cichej awarii i gotowością operacyjną, organizacje mogą bezpiecznie przeprowadzać migrację, zachowując jednocześnie stabilność wymaganą przez systemy o znaczeniu krytycznym.
Migracja przyrostowa odnosi sukces, gdy przewodzi zachowanie, a nie technologia
Przyrostowa migracja komputerów mainframe w środowiskach COBOL, JCL i usługach rozproszonych jest często opisywana jako podróż techniczna, jednak jej sukces zależy od tego, jak dobrze zrozumiane i zachowane jest zachowanie zachowania systemu w trakcie zmian. Największe ryzyko nie wynika z nieznanych platform czy nowoczesnych narzędzi, ale z ukrytych ścieżek wykonywania, fragmentarycznych przepływów danych i zmienionej semantyki awarii, które ujawniają się dopiero po rozpoczęciu migracji. Pominięcie tych aspektów behawioralnych sprawia, że działania przyrostowe tracą przewidywalność i impet.
W środowiskach hybrydowych starsze systemy nadal dostarczają wartość właśnie dlatego, że ich zachowanie jest stabilne i dobrze zrozumiane w środowisku produkcyjnym. Migracja przyrostowa podważa tę stabilność, wprowadzając częściowe zmiany w głęboko sprzężonych modelach wykonania. Każdy etap migracji w subtelny sposób zmienia harmonogram, zależności lub obsługę błędów. Bez świadomego uwzględnienia tych zmian, organizacje kompensują je, stosując obejścia operacyjne, zamiast dążyć do realizacji celów modernizacyjnych.
Przewidywalna transformacja pojawia się, gdy migracja przyrostowa jest traktowana jako dyscyplina inżynierska, a nie sekwencja odizolowanych inicjatyw. Dyscyplina ta priorytetowo traktuje ciągłość wykonywania, przejrzystość zależności i równoważność zachowań w przypadku awarii, a nie szybką ekstrakcję. Kroki migracji stają się mniejsze, bezpieczniejsze i łatwiejsze do uzasadnienia. Wysiłek stabilizacyjny maleje w miarę systematycznego wdrażania wyciągniętych wniosków, umożliwiając stały postęp bez powtarzających się zakłóceń.
Dla przedsiębiorstw modernizujących długotrwałe systemy mainframe, migracja przyrostowa pozostaje najbardziej realną drogą naprzód. Jej obietnica nie tkwi w unikaniu złożoności, ale w świadomym jej zarządzaniu. Gdy zrozumienie behawioralne prowadzi do zmiany architektury, migracja przyrostowa przekształca się ze strategii zarządzania ryzykiem w zrównoważony model modernizacji, który zachowuje zaufanie operacyjne, umożliwiając jednocześnie długoterminową ewolucję systemu.
